Primero llegaron los humanos.
Después, los agentes de IA.
Y ahora, en tu web, tienes a los dos a la vez. Uno entra con el móvil en la mano, se aburre si tarda y se va. El otro entra a hacer cosas en nombre de alguien: buscar un producto, comparar precios, filtrar un catálogo, rellenar un formulario o meter algo en el carrito.
Un agente, para que hablemos de lo mismo, es un programa que actúa por ti. No solo lee tu web como hace un buscador o ChatGPT cuando busca información. La usa.
Y claro, la pregunta del millón es qué hay que cambiar en una web para que estos nuevos visitantes la entiendan y la puedan usar sin liarla. Porque ya te adelanto que te van a intentar vender unas cuantas cosas que no sirven para nada.
Así que vamos allá. Primero, cómo te ven. Después, lo que te puedes ahorrar. Y al final, lo que sí merece la pena.
Cómo ‘ve’ un agente de IA tu web
Si te quedas con una sola cosa de todo el artículo, que sea esta.
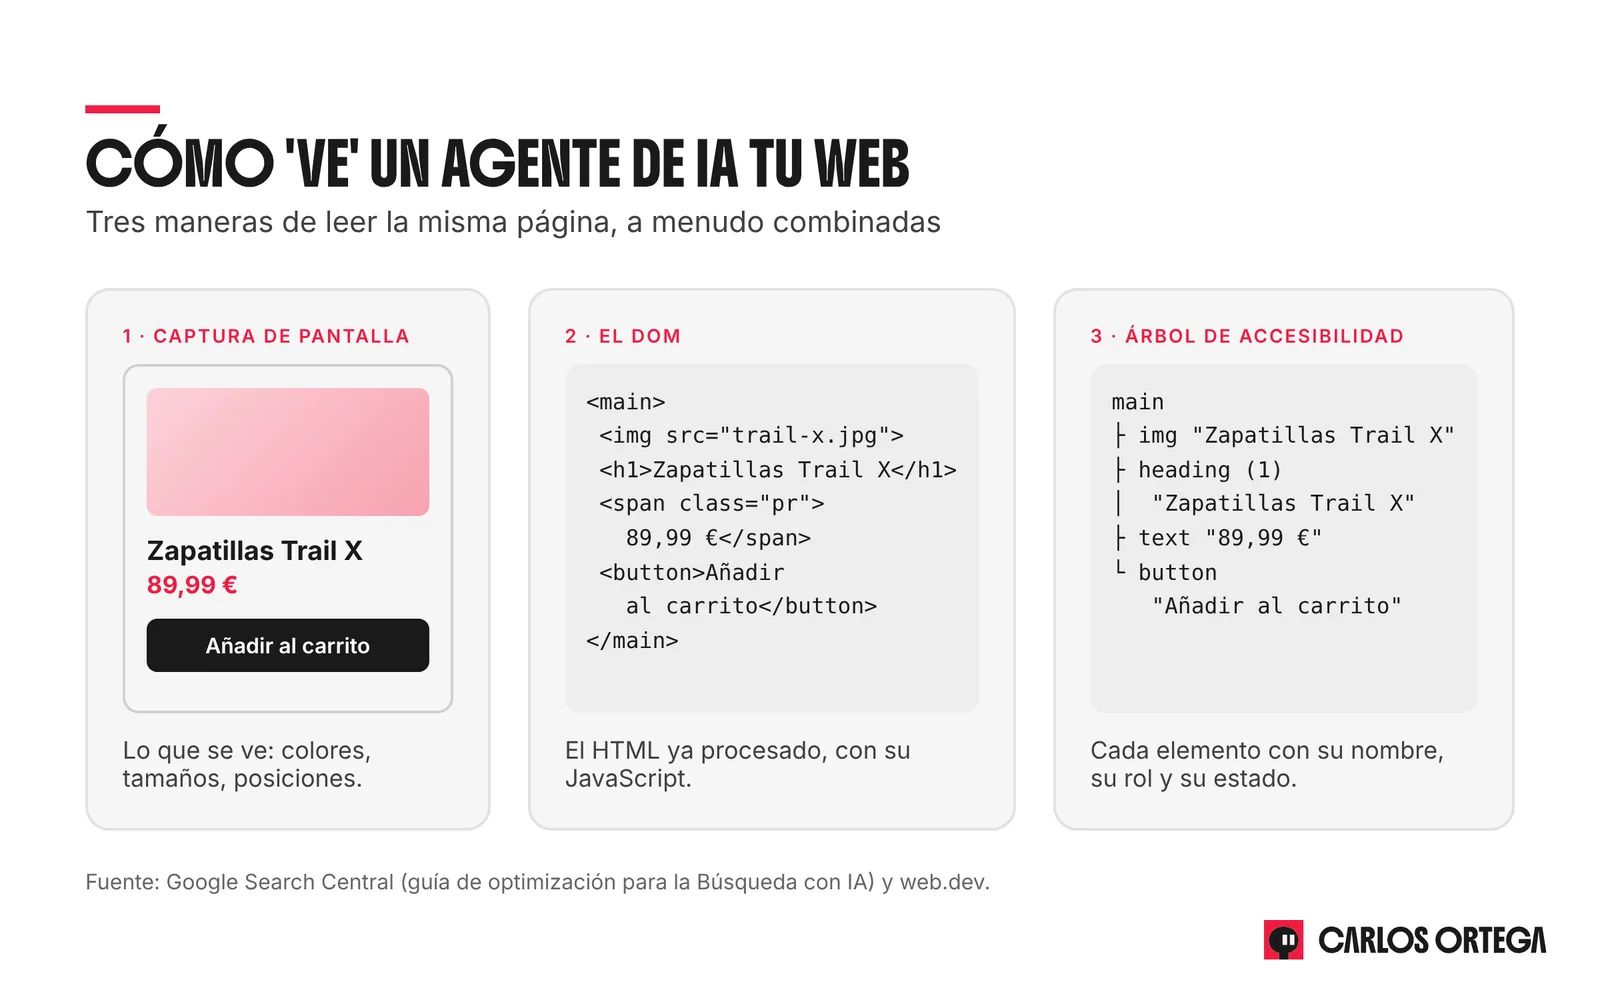
Un agente no ve tu web como tú. La ‘ve’ de tres maneras distintas, y muchas veces combinándolas:
- Una captura de pantalla. Literalmente una imagen de cómo se ve la página, que analiza con un modelo de visión.
- El DOM. El HTML ya procesado, después de ejecutar el JavaScript.
- El árbol de accesibilidad. La versión ‘estructurada’ que monta el navegador para los lectores de pantalla, con cada elemento, su nombre, su rol (botón, enlace, encabezado…) y su estado.
Y esto no me lo invento yo. Lo cuenta Google en su guía de optimización para las funciones de IA generativa de la Búsqueda: los agentes de navegador pueden entender tu web analizando su renderizado visual (como las capturas de pantalla), inspeccionando la estructura del DOM e interpretando el árbol de accesibilidad.
Lo del DOM no es nuevo para los que llevamos años peleándonos con el JavaScript y Google. Si nunca lo has mirado, en 6 formas de ver tu web como si fueras Google te cuento cómo comprobarlo. Con los agentes pasa algo parecido, solo que ahora también miran y hacen clic.
Con esto en mente, vamos a separar el grano de la paja.
Lo que NO te hace falta optimizar
Empiezo por aquí porque es donde más humo se está vendiendo. Hay tres cosas que te van a recomendar sí o sí cuando preguntes cómo preparar tu web para la IA: duplicar tus páginas en Markdown, crear un llms.txt y pelearte con el robots.txt.
Y ojo, que no digo que hagan daño. Digo que, a día de hoy, no te van a aportar nada. Vamos una por una.
Versiones en Markdown de tus páginas
Hay quien recomienda tener cada página duplicada en Markdown (.md) para que los LLMs la lean ‘más fácil’, sin menús, sin anuncios y sin JavaScript de por medio.
Si tienes curiosidad por ver cómo quedaría la tuya, puedes poner esto delante de cualquier URL:
https://r.jina.ai/tu-URLCurioso, sí. ¿Útil? No mucho. Por tres razones:
- Esfuerzo duplicado. Tienes que mantener dos versiones de cada página. Siempre. Y el día que cambies un precio en una y no en la otra… ya la tienes liada.
- Posible ‘cloaking’. Le estás enseñando a unos bots un contenido distinto del que ven las personas. Y eso a Google, de toda la vida, no le hace ninguna gracia.
- No las usan. Y esta es la importante.
Lo dice la propia Google en esa misma guía, en el apartado de mitos: no hace falta que crees archivos nuevos legibles por máquinas, archivos de texto para IA, etiquetado especial ni Markdown para aparecer en la Búsqueda.
Y lo confirma la práctica. OtterlyAI hizo un experimento de 14 días publicando versiones HTML y Markdown de las mismas páginas, enlazadas igual desde el pie de su web. Resultado: 137 visitas de bots de IA a las versiones HTML y cero a las Markdown. Y ninguna plataforma (ChatGPT, AI Overviews ni Perplexity) citó una sola URL .md.
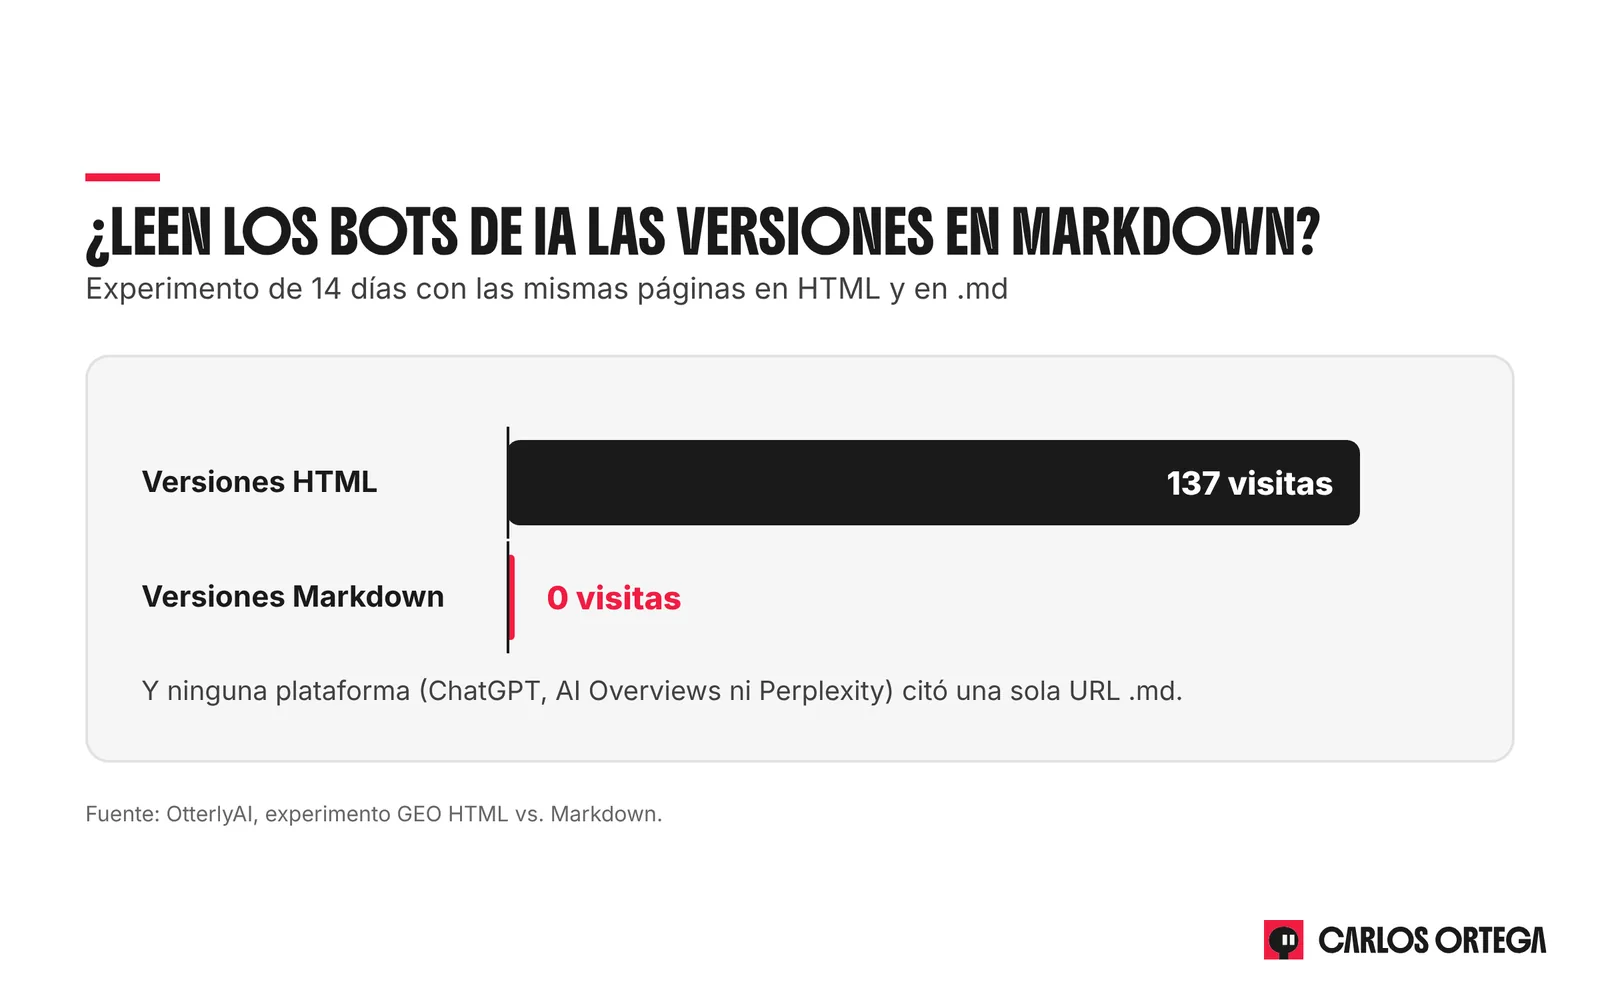
Cero. Más claro, agua.
Y tiene toda la lógica del mundo. Los rastreadores de IA están hechos para leer la web tal cual es, y la web es HTML. Además, lo que les ayuda a entender una página (los datos estructurados, los enlaces internos, la jerarquía de encabezados, las etiquetas meta) vive en el HTML. En un .md todo eso desaparece.
O sea, que con la versión en Markdown no solo trabajas el doble. Encima le quitas pistas al que la lee.
El famoso llms.txt
El llms.txt es una propuesta para tener en la raíz de tu web un archivo de texto con un resumen de tu sitio pensado para los LLMs. Sus defensores lo justifican más o menos así:
Las páginas web están hechas para personas. Una página HTML envuelve su información entre navegación, anuncios y JavaScript, y convertirla de nuevo en texto limpio es difícil e impreciso. La mejor manera de servir a los agentes es con información concisa y de alto nivel, concentrada en una única ubicación accesible.
Suena bien, ¿verdad? El problema es que nadie lo lee.
Google lo mete en el mismo saco que el Markdown: no pasa nada si lo creas, pero no te va a ayudar ni a perjudicar en la Búsqueda, porque lo ignora.
Pero es que además hay datos. Ahrefs analizó 137.210 dominios durante mayo de 2026:
- Unos 38.000 tenían llms.txt (el 28%).
- El 97% de esos archivos no recibió ni una sola visita en todo el mes.
- Entre todos sumaron unas 22.000 peticiones, y el 96% eran bots.
- Los bots de IA fueron el 19,5% del total. Y dentro de ese grupo, los agentes de IA, apenas el 10,5%.
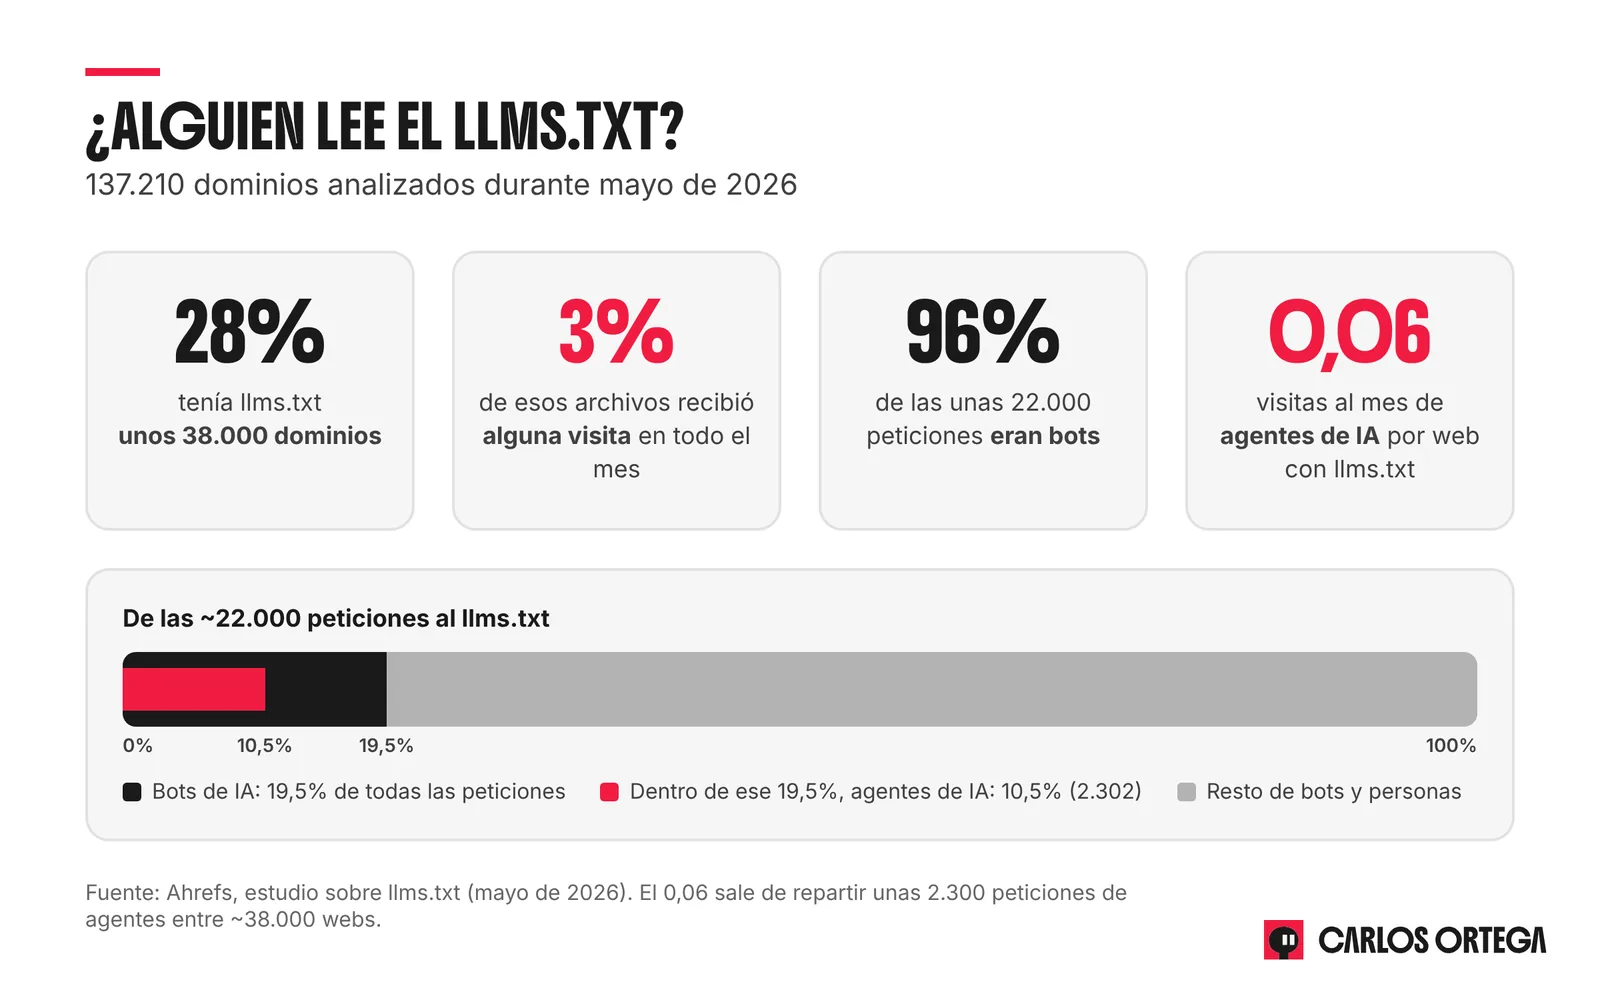
Si repartes esas peticiones de agentes entre las más de 38.000 webs que lo tenían, sale a 0,06 visitas al mes por web. Vamos, que le haces más caso tú a tu llms.txt que cualquier IA.
No es la primera vez que lo digo, y me temo que no será la última. Ya conté en GEO, LLMO, AEO… y demás nombres de mierda para intentar vender SEO por qué desconfío de todo lo que se vende como ‘lo nuevo’ para salir en la IA. El llms.txt es el ejemplo perfecto.
Bloquear o permitir agentes en el robots.txt
Este es más sutil.
Mucha gente se pasa horas decidiendo qué bots de IA bloquea o deja pasar en su robots.txt. Y para los rastreadores ‘de siempre’ tiene todo el sentido (si no tienes claro cómo funciona el rastreo, te lo explico a fondo en mi guía de rastreo e indexación).
Pero con los agentes la cosa cambia.
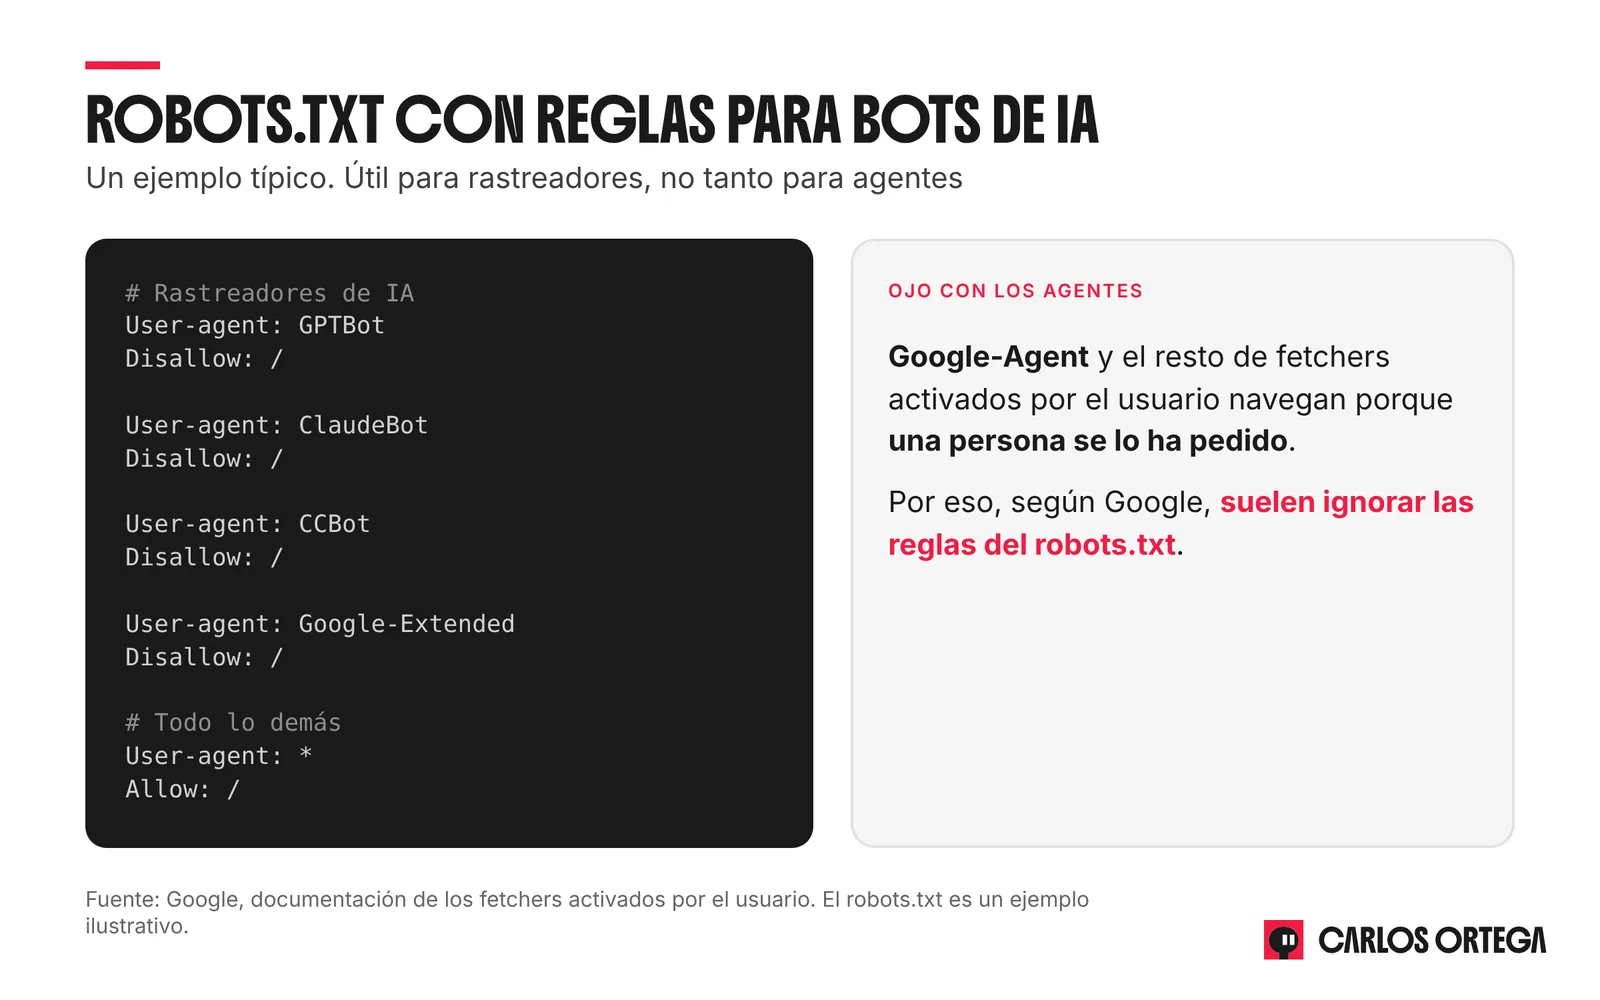
Google ya tiene documentado Google-Agent, el que usan los agentes alojados en su infraestructura para navegar por la web y hacer acciones cuando un usuario se lo pide. Y en esa misma página explica algo clave sobre este tipo de visitantes:
Como la petición la ha hecho un usuario, estos fetchers suelen ignorar las reglas del robots.txt.
Tiene su lógica. Si un agente entra en tu web porque una persona le ha pedido que lo haga, en la práctica es como si entrara esa persona. Así que con los agentes el robots.txt no es la herramienta que te va a salvar. Ni la que te va a hundir.
Lo que SÍ te hace falta optimizar
Ahora sí. Vamos a lo que de verdad marca la diferencia.
Si quieres ver tu web con los ojos de un agente mientras lees el resto, hice una extensión gratuita para Chrome, Agentic View. Te enseña la captura con los controles numerados, el árbol de accesibilidad, qué botones no tienen nombre o están tapados y las diferencias entre el HTML del servidor y el DOM.
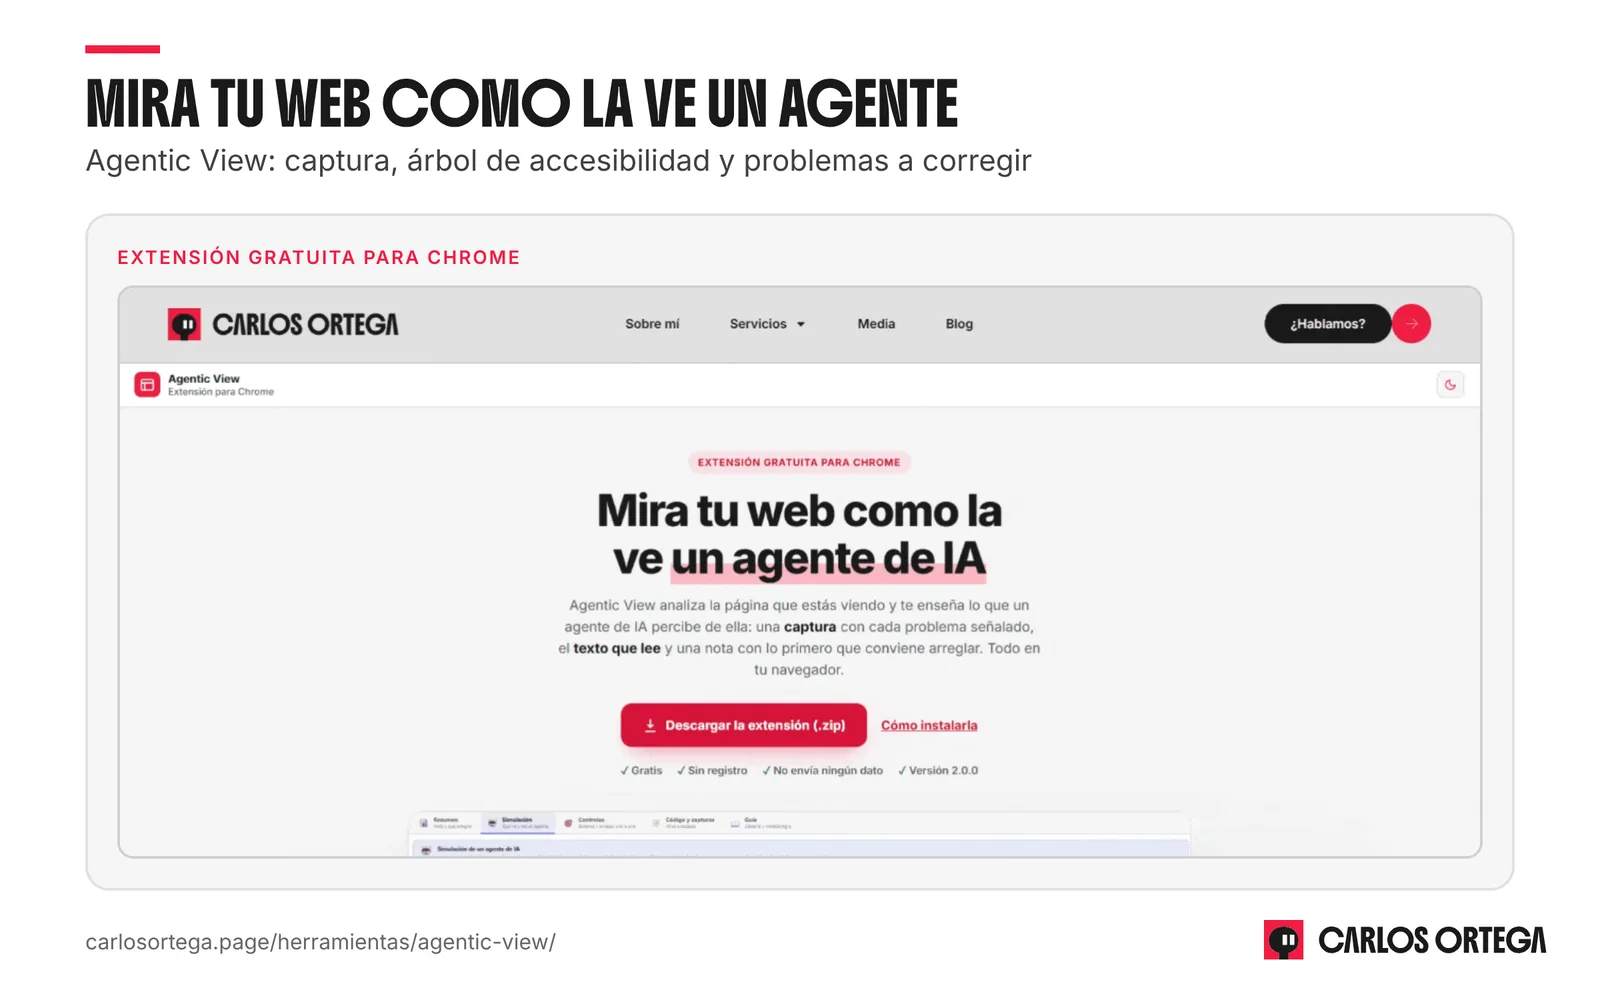
Tenla a mano, porque te va a servir para comprobar en tu propia web cada uno de los cinco puntos que vienen ahora: el CLS, los datos estructurados, los encabezados, el HTML semántico (con su ARIA) y WebMCP. Los he ordenado de lo más básico a lo más nuevo.
1. El CLS (que no se te mueva la web)
El CLS (Cumulative Layout Shift) es una de las Core Web Vitals y mide la estabilidad visual: cuánto ‘bailan’ los elementos de tu página mientras carga.
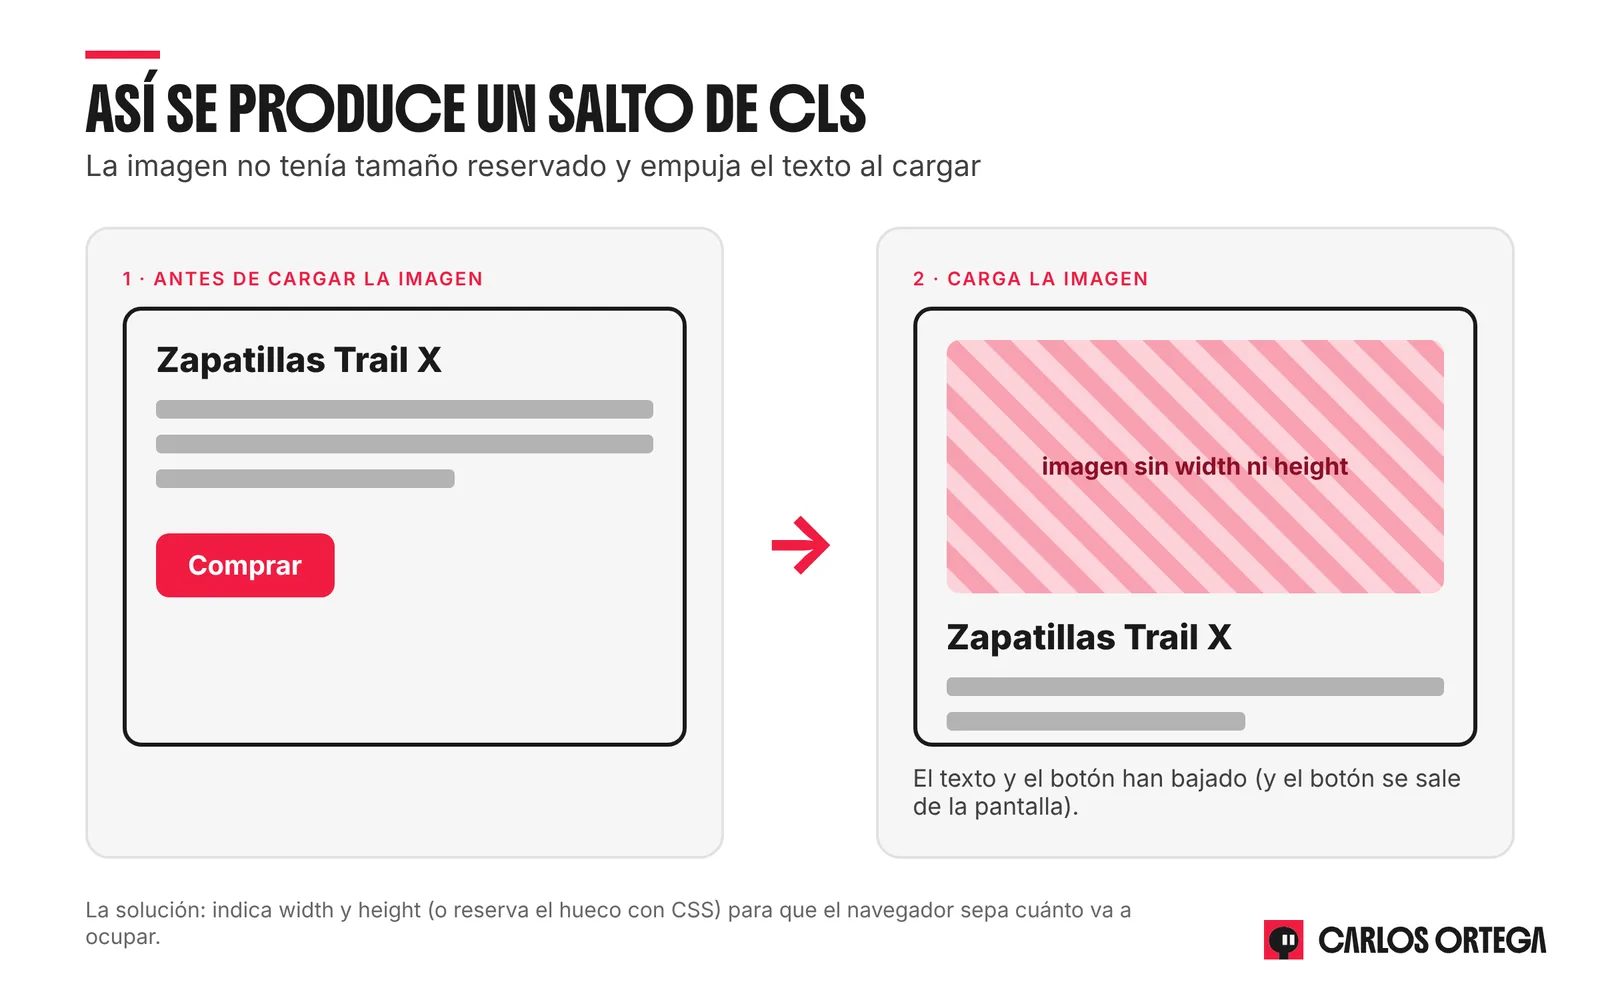
El ejemplo clásico. Tienes un texto y, encima, una imagen o un anuncio que todavía no ha cargado. El navegador pinta el texto. De repente carga la imagen, que no sabía cuánto iba a ocupar, y empuja todo hacia abajo.
Si le dices al navegador qué tamaño va a tener ese elemento (con width y height, o reservando el hueco con CSS), no se mueve nada. Si no se lo dices, salto.
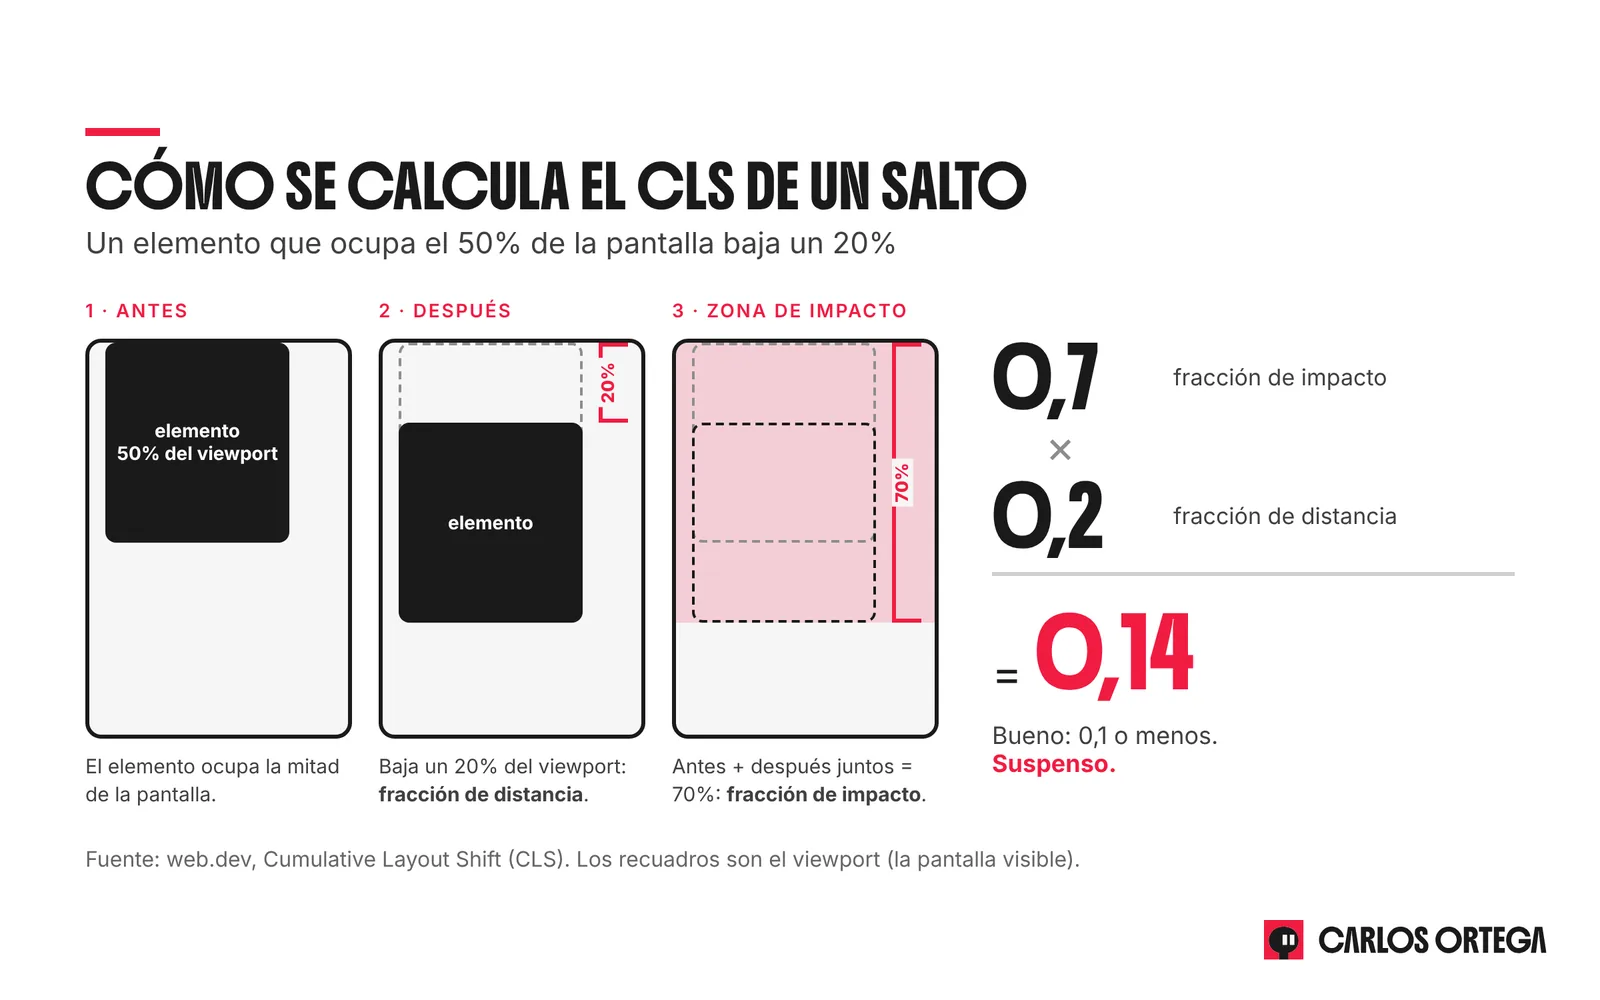
El cálculo, por si tienes curiosidad, es bastante sencillo. Según web.dev, cada salto se calcula multiplicando dos fracciones:
- La fracción de impacto: qué parte de la pantalla se ve afectada. Si el elemento ocupa el 50% y baja un 20%, entre el antes y el después afecta al 70% del viewport: 0,7.
- La fracción de distancia: cuánto se ha movido respecto a la pantalla. En este caso, un 20%: 0,2.
0,7 × 0,2 = 0,14 de CLS. Y Google considera bueno un CLS de 0,1 o menos. Suspenso.
¿Y qué tiene que ver esto con los agentes? Pues muchísimo. Acuérdate de que uno de sus tres ‘ojos’ es una captura de pantalla.
En su guía para crear webs pensadas para agentes, el equipo de Chrome explica que, a partir de la captura, un agente puede deducir que una barra de búsqueda arriba a la derecha es una búsqueda global y que una caja en mitad de la página probablemente sea un campo de formulario. Se fija en el color, el tamaño y la proximidad para decidir qué es importante.
Y justo después avisa:
Los agentes que hacen capturas de pantalla probablemente se confundirán si el diseño de tu web cambia constantemente.
Imagina la escena. El agente hace la captura y piensa ‘este botón debe de ser para comprar el juego’. Va a hacer clic… y justo en ese momento carga un banner y lo que hay debajo es otra cosa.
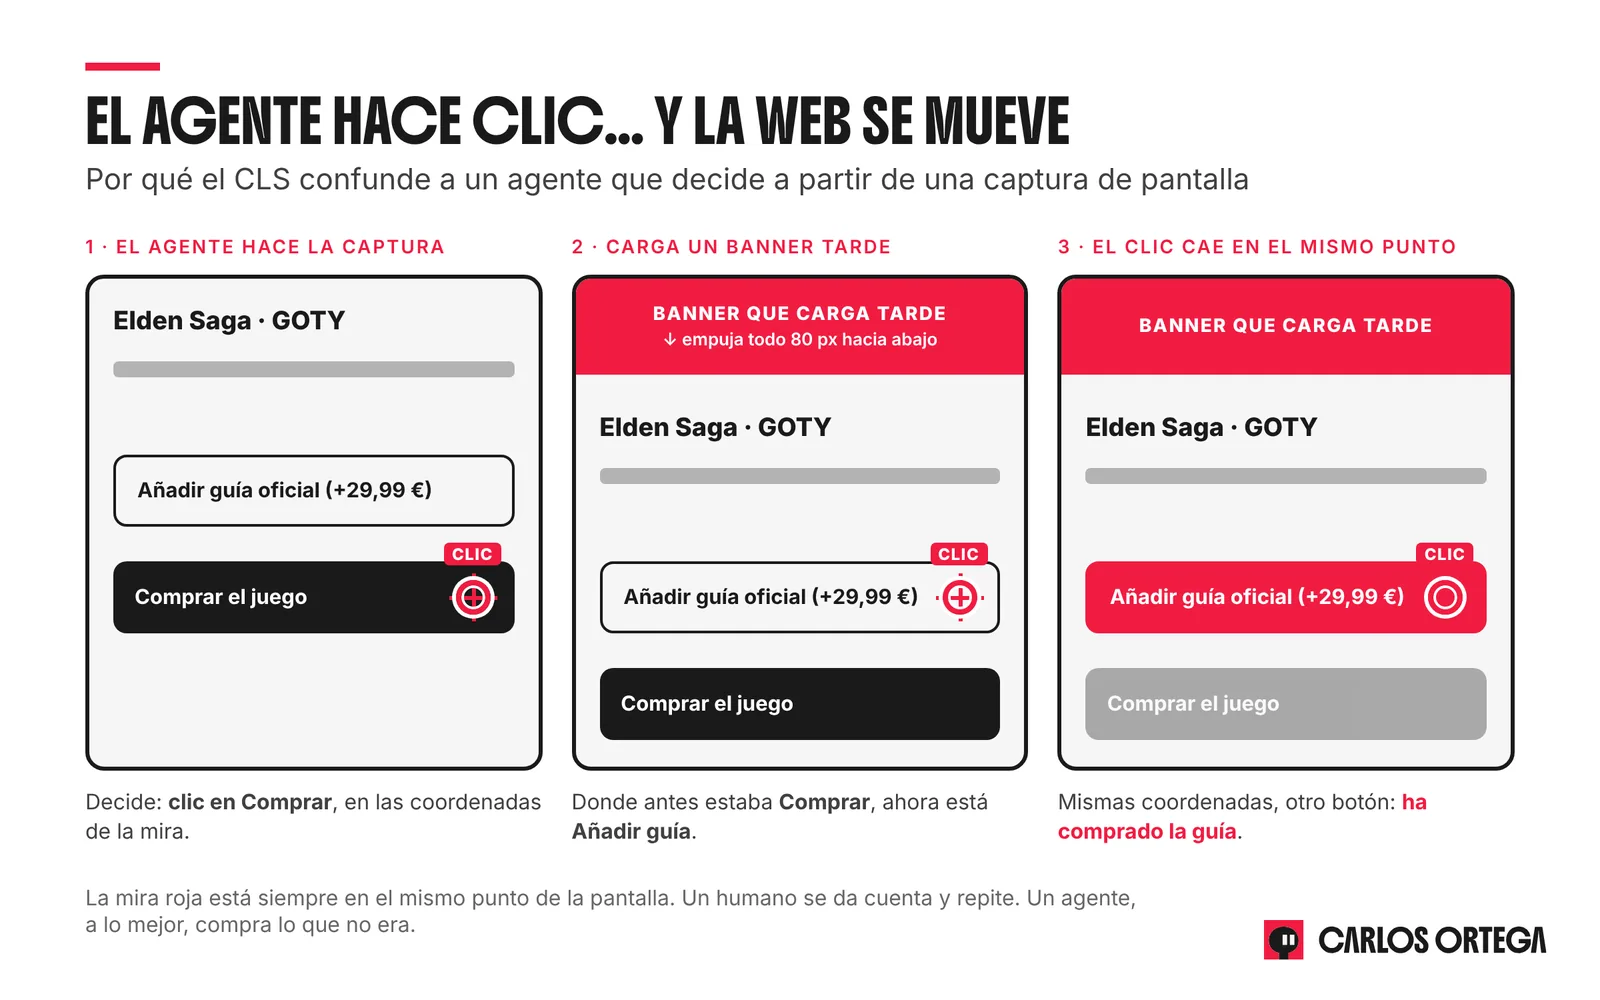
Un humano se cabrea y vuelve a intentarlo. Un agente, a lo mejor, compra lo que no era. O directamente se rinde y se va a la web de tu competencia.
Para revisarlo tienes WPO Analyzer, otra herramienta gratuita que mide el rendimiento real de cualquier URL con Lighthouse y te dibuja todo lo que carga.
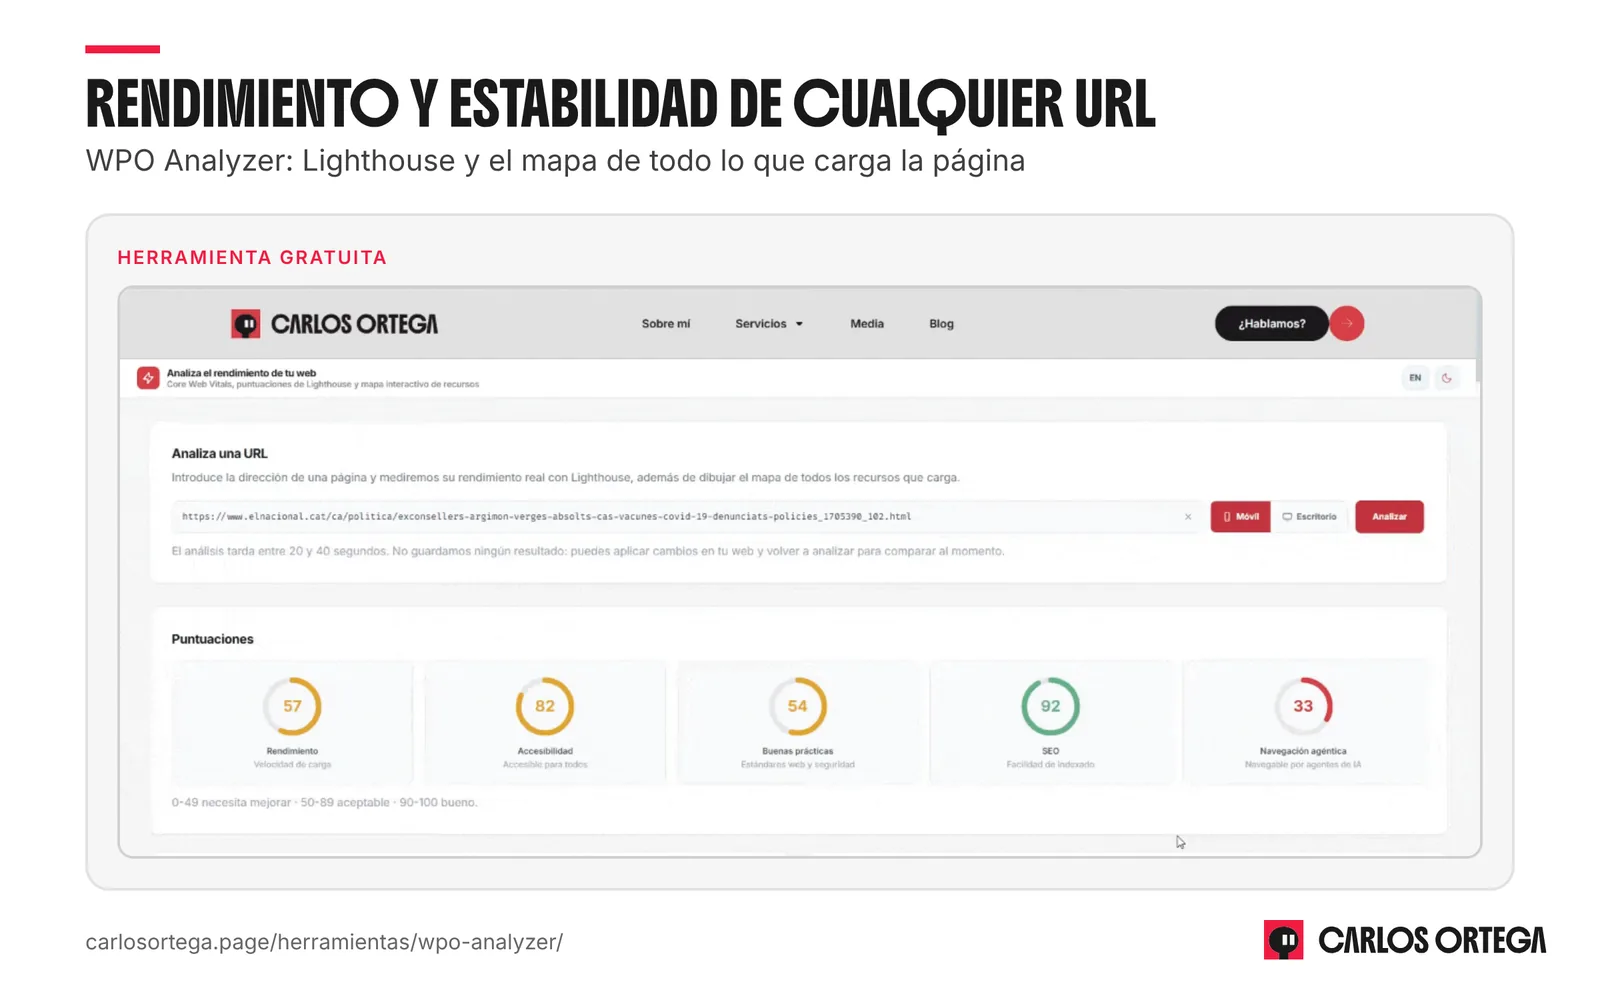
Mi consejo: no te quedes solo con la nota de una prueba de laboratorio. Mira también el CLS de tus usuarios reales en el informe de Core Web Vitals de Search Console, y céntrate primero en las plantillas que más visitas reciben (fichas de producto, artículos, categorías) en móvil, que es donde más se suele mover todo.
Si ahí está en verde, el agente que haga una captura de tu página verá lo mismo que va a encontrarse cuando haga clic. Que es justo lo que queremos.
2. Los datos estructurados
Los datos estructurados son ese código (normalmente en JSON-LD) con el que le dices de forma explícita a las máquinas de qué va tu página. Schema.org tiene más de 800 tipos y unas 1.500 propiedades, así que hay para aburrir.
Para que lo veas claro. Una ficha de producto cualquiera: ¿eso de arriba es el nombre o la marca? ¿El precio es el tachado o el otro? ¿La foto es el producto o un banner? Un humano lo pilla al vuelo. Un agente tiene que adivinarlo. Con datos estructurados, se lo das masticado.
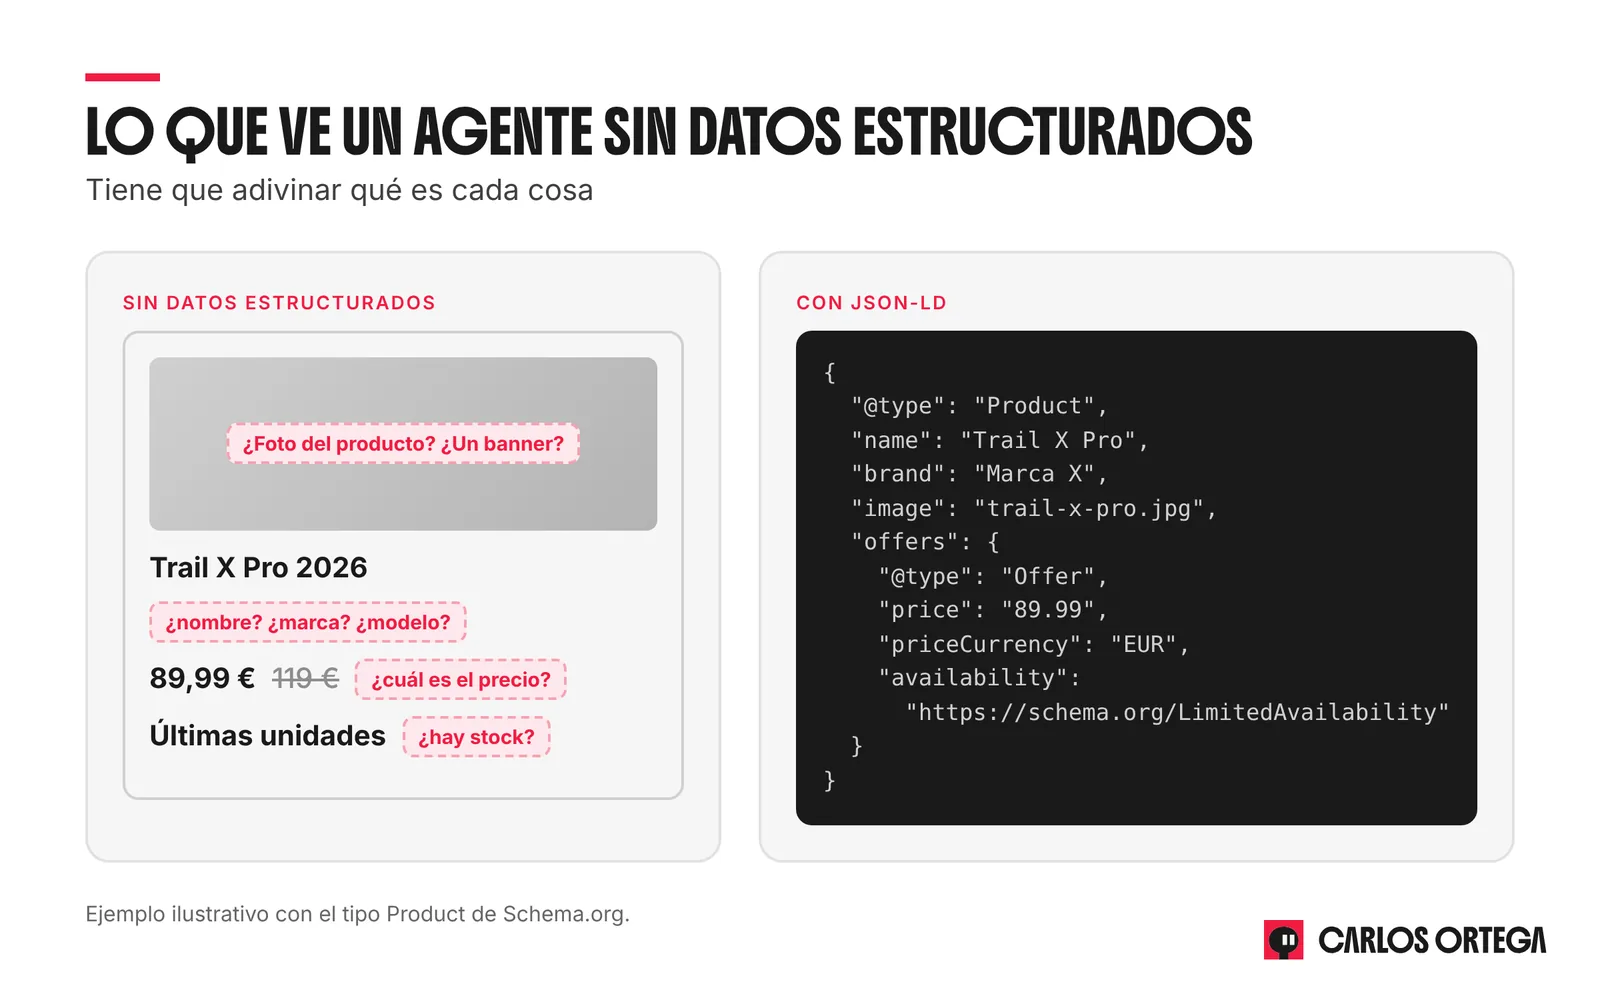
Para un agente sirven sobre todo para tres cosas: saber qué tipo de página está viendo, saber de quién o de qué habla y saber cómo se relaciona con todo lo demás. Te lo explico con un ejemplo friki, que para eso es mi blog.
Desambiguar intenciones
¿Esta página es un artículo informativo, una página de servicio o un curso? Muchas veces, a simple vista, no está tan claro. Las tres tienen un título, un texto, una imagen y un botón.
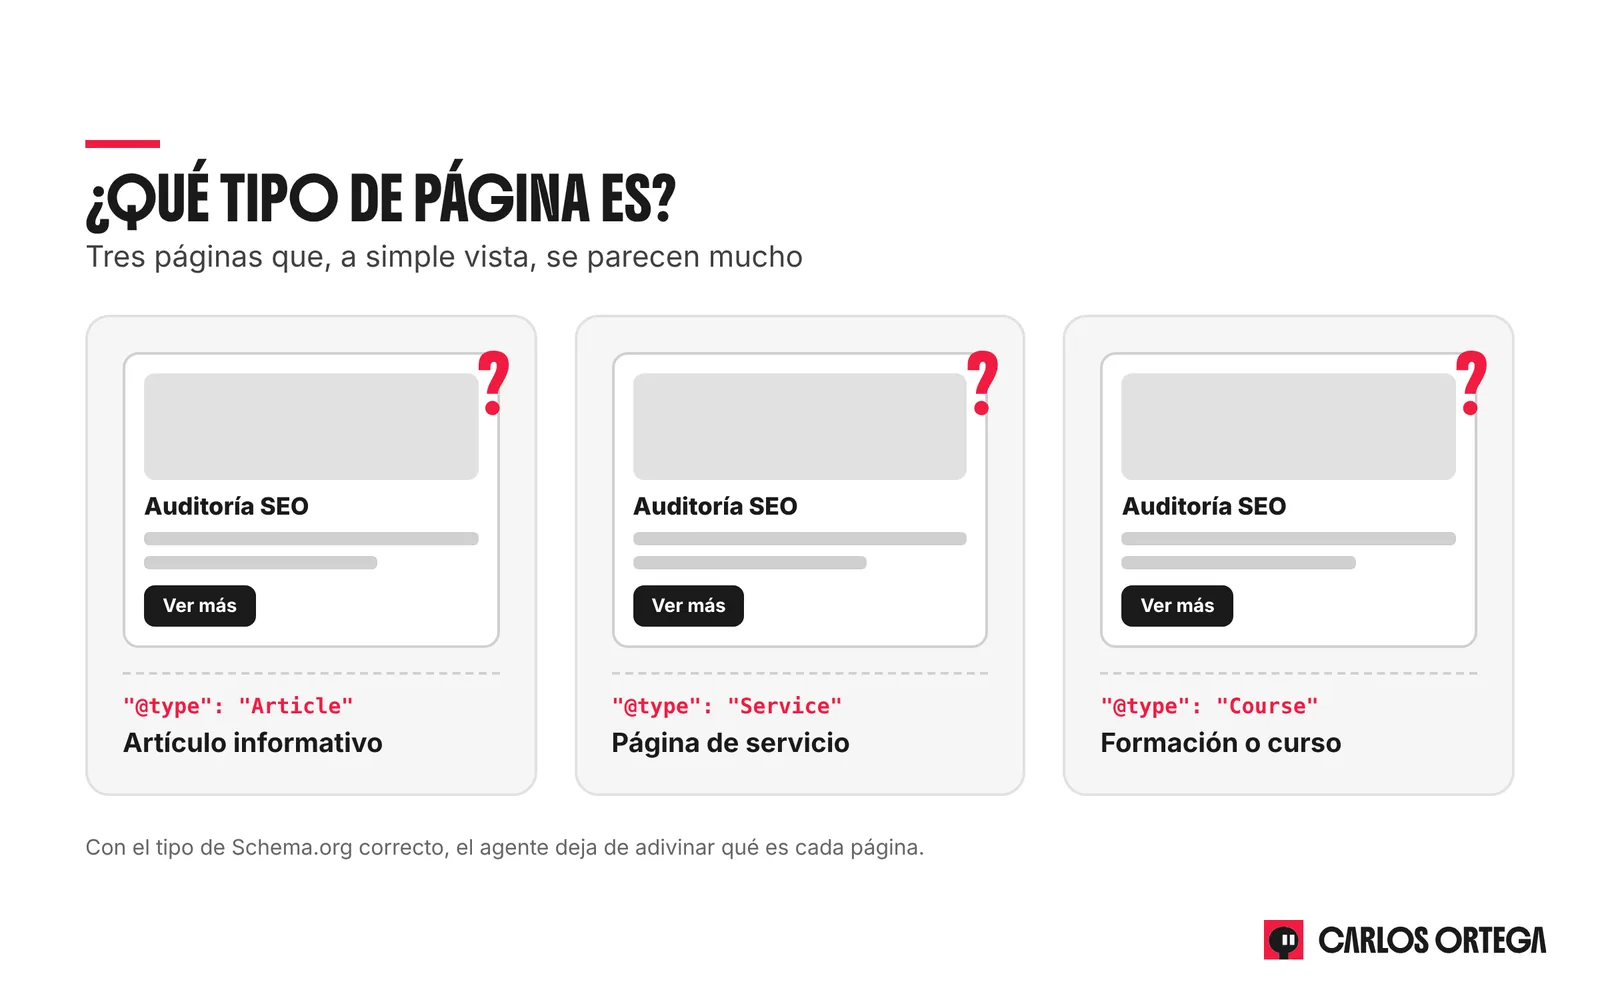
Si lo marcas con el tipo que toca (Article, Service, Course…), el agente deja de tener que suponerlo. Y no es lo mismo que te tome por un blog cuando alguien le ha pedido ‘contrata una auditoría SEO‘ que saber que esa página es justo el servicio que busca.
Desambiguar entidades
Si te digo ‘Goku’, ¿de quién hablo? ¿De Son Goku? ¿De Goku Jr.? ¿De Bardock, que es clavadito? Si encima tu web va de Dragon Ball, tienes a Son Goten, a Turles… medio reparto se da un aire.
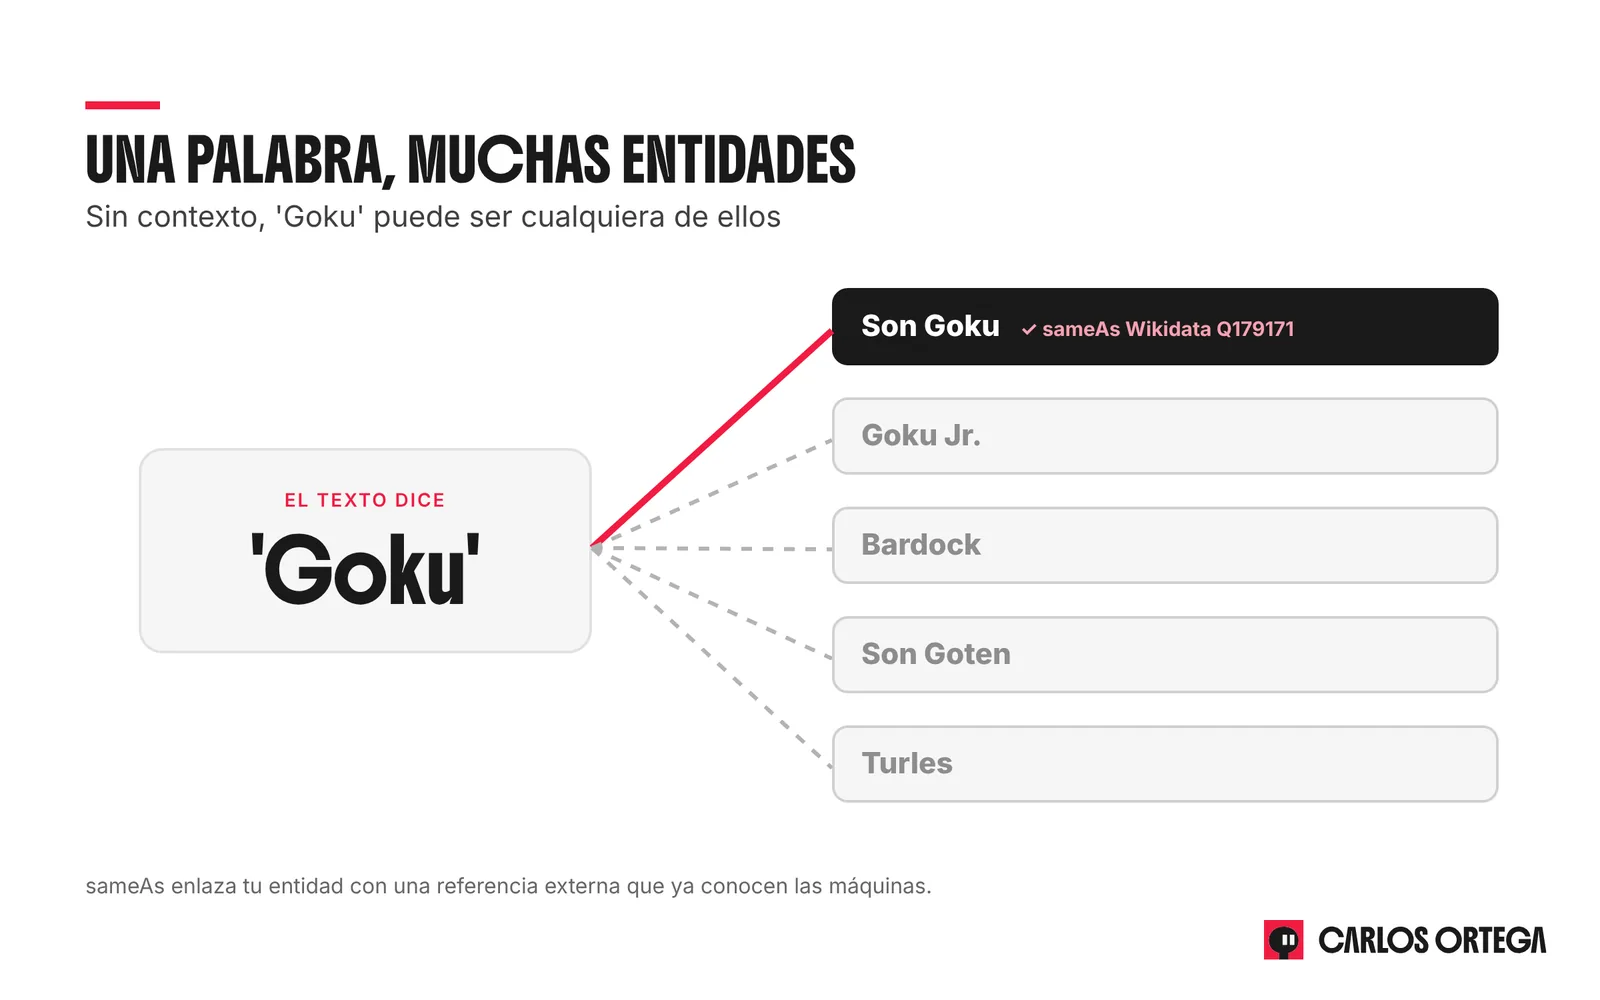
Con datos estructurados lo dejas clarísimo, sobre todo gracias a sameAs, que enlaza la entidad con referencias externas que ya conocen todas las máquinas, como la Wikipedia o Wikidata:
{
  "@type": "Person",
  "name": "Son Goku",
  "alternateName": ["Goku", "Kakarot"],
  "sameAs": [
    "https://es.wikipedia.org/wiki/Son_Goku",
    "https://www.wikidata.org/wiki/Q179171"
  ]
}
Con esas pocas líneas ya no hay duda posible: es este Goku y no otro.
Establecer relaciones
Y no solo dices quién es. También con quién se relaciona: su pareja, sus hijos, la familia de cada uno… Con propiedades como spouse, children o parent, todo eso queda conectado en un mismo grafo.
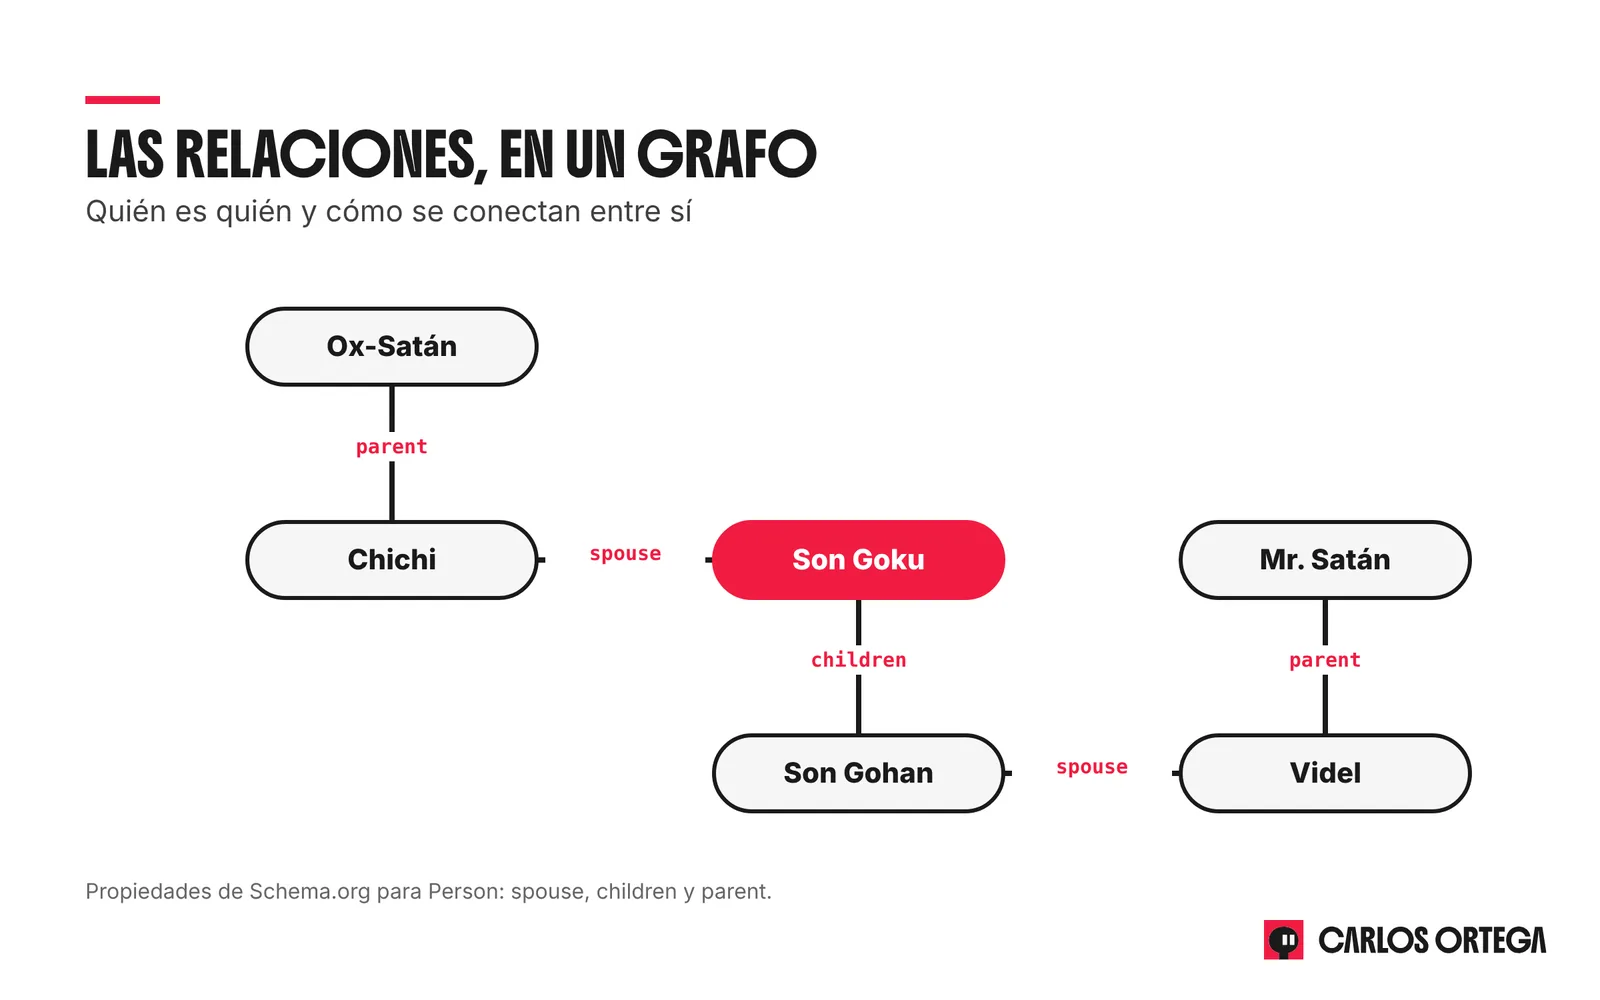
En código, la parte de la pareja y el primer hijo quedaría más o menos así:
"spouse": { "@type": "Person", "name": "Chichi" },
"children": [
  { "@type": "Person", "name": "Son Gohan" }
]
Cambia a Goku por tu empresa, tus productos, tus autores o tus servicios y pasa exactamente lo mismo. Cuanto mejor conectado esté todo, menos tiene que suponer el agente.
Eso sí, ojo. Google es muy clara en su guía: los datos estructurados no son obligatorios para aparecer en la búsqueda con IA generativa. No son una varita mágica. Son una ayuda más para que te entiendan mejor.
Para ver los de cualquier página en forma de grafo, con todos sus anidamientos, puedes usar Visual Schema. Y si quieres algo más rápido para revisar los de cualquier web, tienes también Schema Checker.
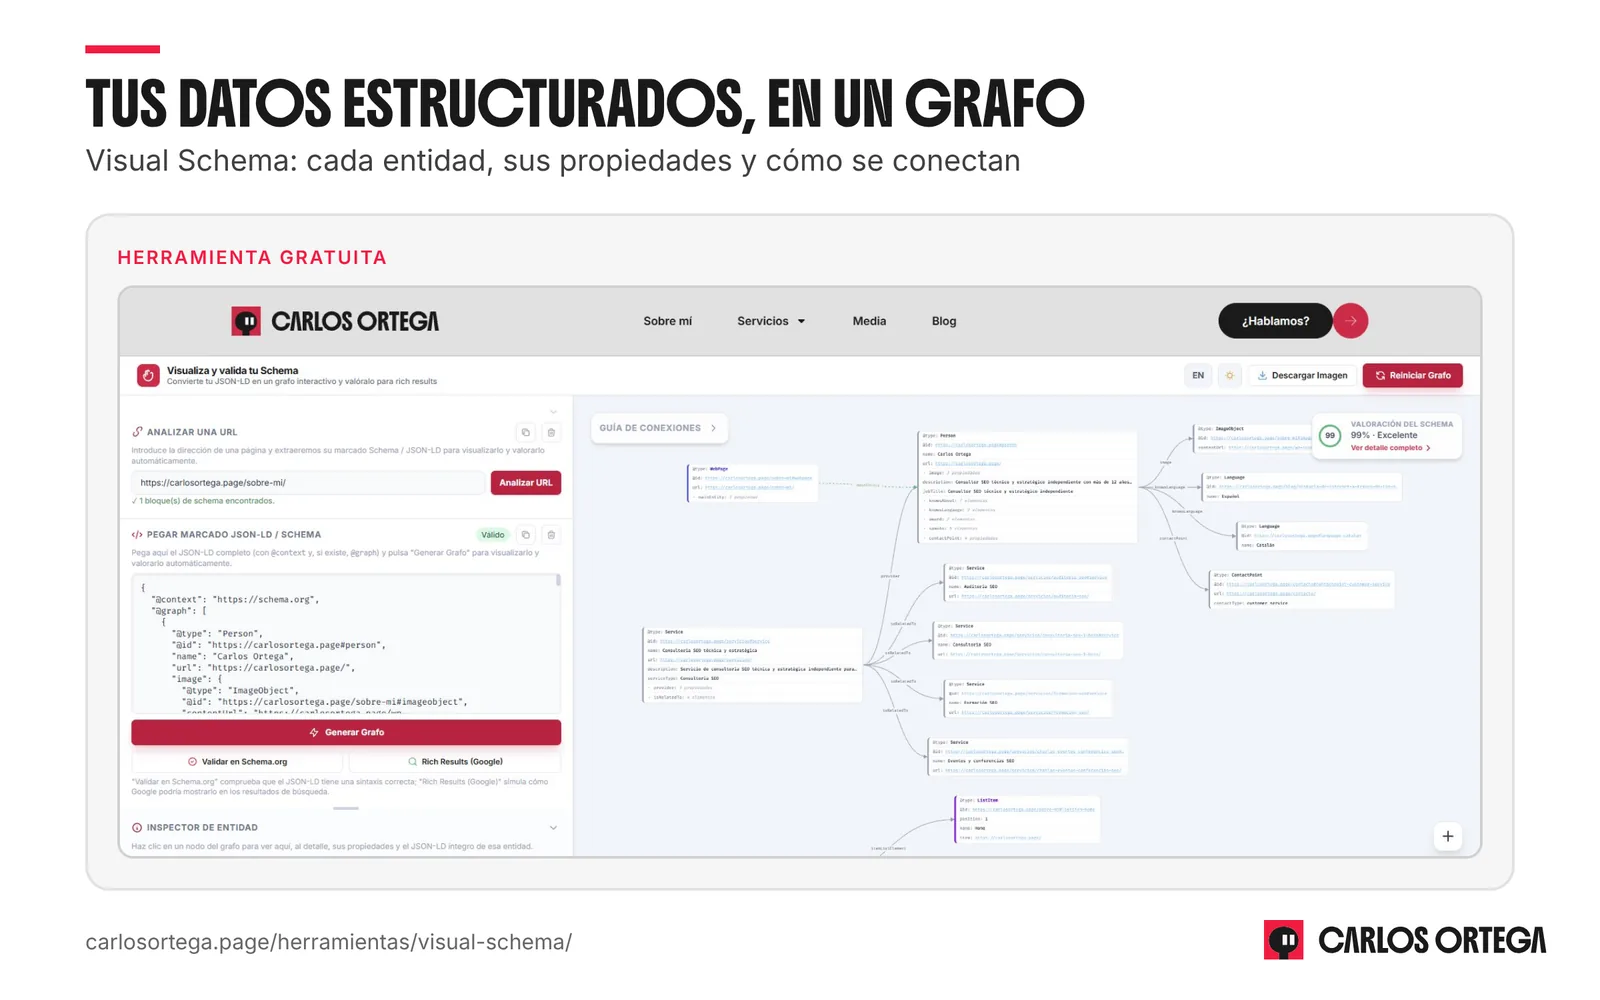
Fíjate sobre todo en si las piezas están conectadas entre sí (la organización con su web, el artículo con su autor, el producto con su oferta) o si cada bloque va por libre. Es lo más habitual cuando se mezclan varios plugins, y es justo lo que impide que el agente entienda el conjunto.
3. Los encabezados HTML
Este parece de primero de SEO. Y lo es. Pero sigue fallando muchísimo.
Los encabezados (H1, H2, H3…) son el índice de tu página. Para una persona con un lector de pantalla, y para un agente que lee el DOM o el árbol de accesibilidad, son el mapa para orientarse.
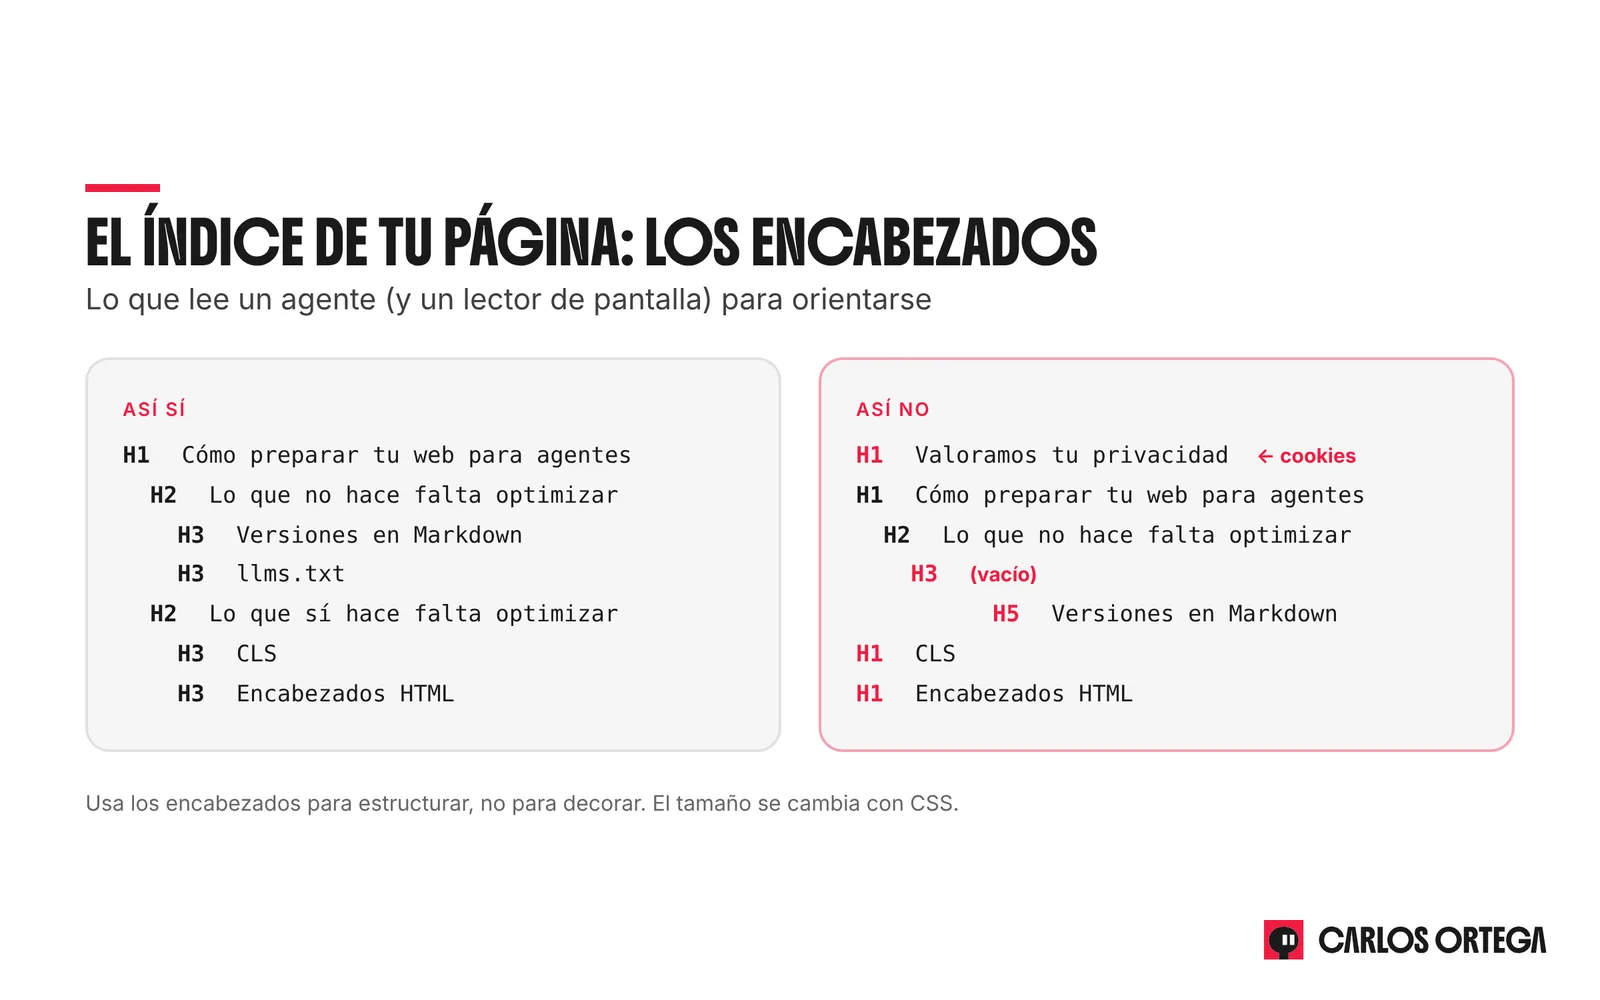
Encabezados vacíos, saltos de nivel porque ‘el H5 queda más bonito’, varios H1 porque el diseño lo pedía… Y mi favorito: el banner de cookies con un H1 ‘Valoramos tu privacidad’, que se cuela como título principal de todas tus páginas sin que nadie se dé cuenta.
Usa los encabezados para estructurar, no para decorar. El tamaño se cambia con CSS.
4. El HTML semántico (y el ARIA, con cuidado)
Seguimos con lo básico que casi nadie hace bien.
Una web montada a base de div y span puede verse exactamente igual que una hecha con HTML semántico. Pero en la segunda, un agente (o un lector de pantalla) sabe al instante dónde está la cabecera, dónde el contenido principal y dónde el pie. Son los famosos landmarks.
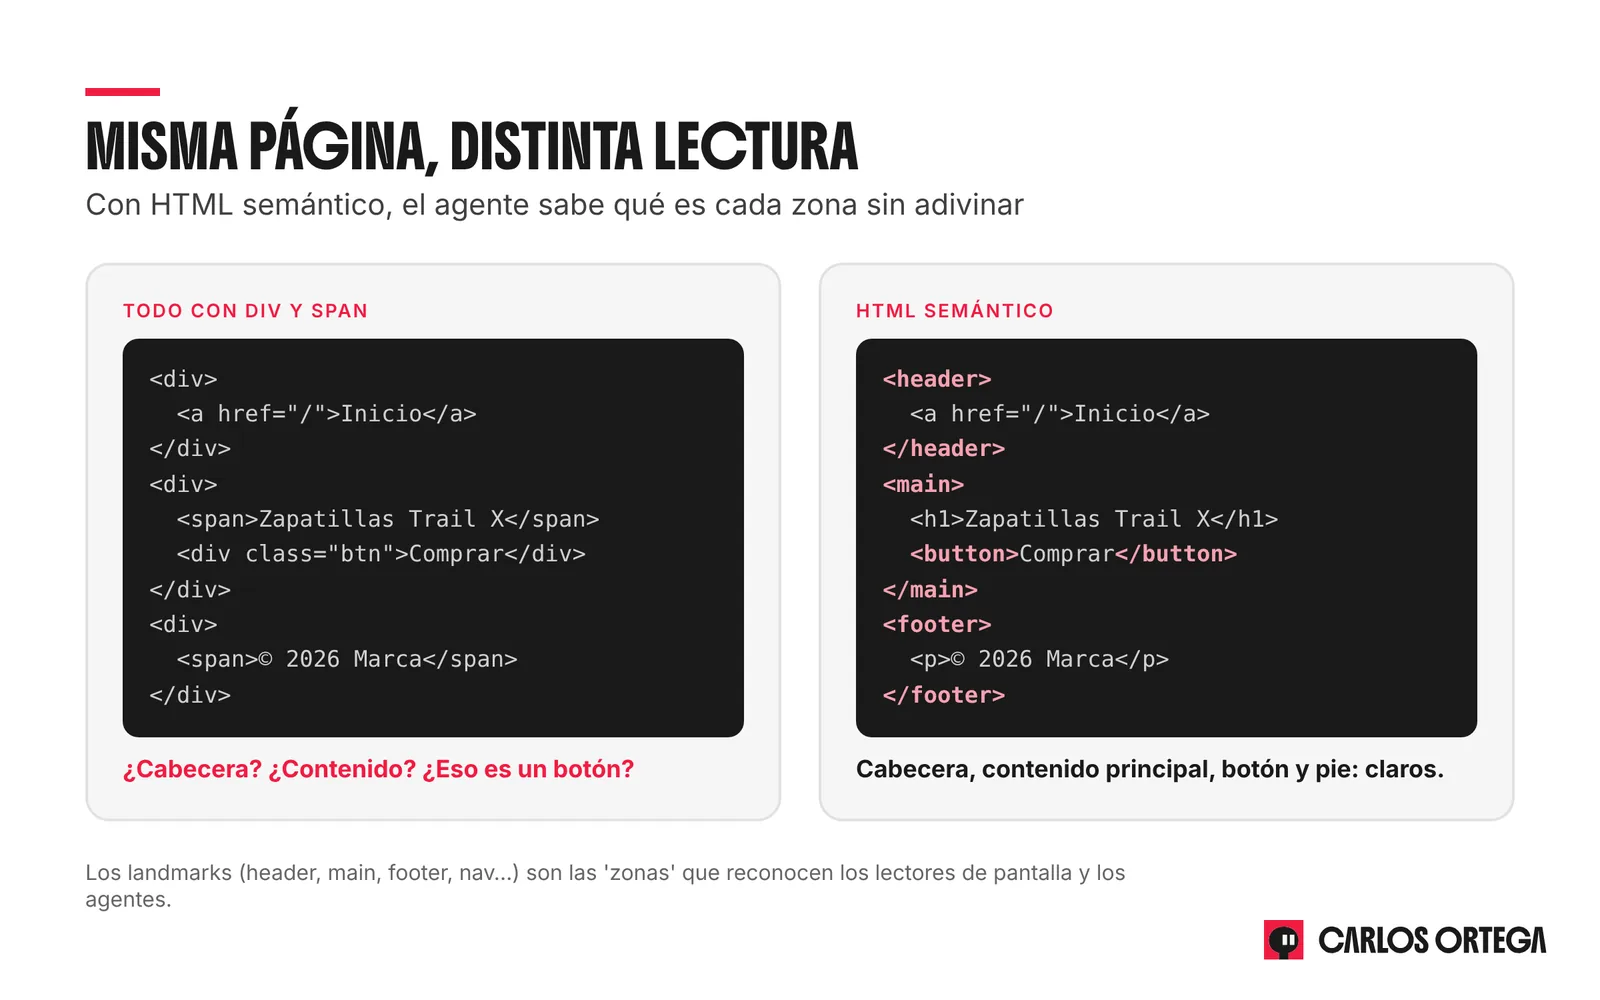
La guía de Chrome para agentes va en la misma línea: usa elementos como button y a en lugar de div o span ‘disfrazados’, porque los agentes los reconocen como interactivos. Y Google, en su guía para la Búsqueda con IA, lo deja caer también: no es obligatorio tener un HTML perfectamente semántico, pero suele ser buena idea porque ayuda a otro tipo de usuarios.
Y luego está ARIA (Accessible Rich Internet Applications). Como lo define web.dev:
ARIA no es un lenguaje de programación en sí, sino un conjunto de atributos que puedes añadir a los elementos HTML para mejorar su accesibilidad.
Básicamente, le dices a un elemento su rol (qué es), su nombre (cómo se llama) y su estado (cómo está):
<div
  role="button"
  aria-label="Añadir a favoritos"
  aria-pressed="false">
  <img src="/icons/corazon.svg" alt="">
</div>
Gracias a esto, un agente sabe que ese corazoncito es un botón, que sirve para añadir a favoritos y que ahora mismo no está pulsado.
Pero ojo. En el mundillo de la accesibilidad hay una frase que es puro oro: ‘No ARIA is better than bad ARIA’. Mejor nada de ARIA que un ARIA mal puesto. De hecho, la primera regla del W3C para usar ARIA es, básicamente, no usarlo si existe un elemento HTML que ya hace lo mismo.
Y los datos lo respaldan. Según el WebAIM Million de 2026, que analiza la accesibilidad del millón de webs más visitadas, las páginas de inicio con ARIA tuvieron de media 59,1 errores, frente a los 42 de las que no lo usaban.
Ojo, eso no quiere decir que ARIA provoque los errores (las páginas con ARIA suelen ser más complejas). Pero sí deja claro que meterlo a lo loco no arregla nada. Primero, HTML semántico. Si un botón puede ser un button, que sea un button. Y ARIA, solo donde haga falta.
Para auditar el árbol de accesibilidad de cualquier página, y ver lo que una IA entiende de ella, tienes Tree Checker, que además te dice de qué guía oficial sale cada aviso.
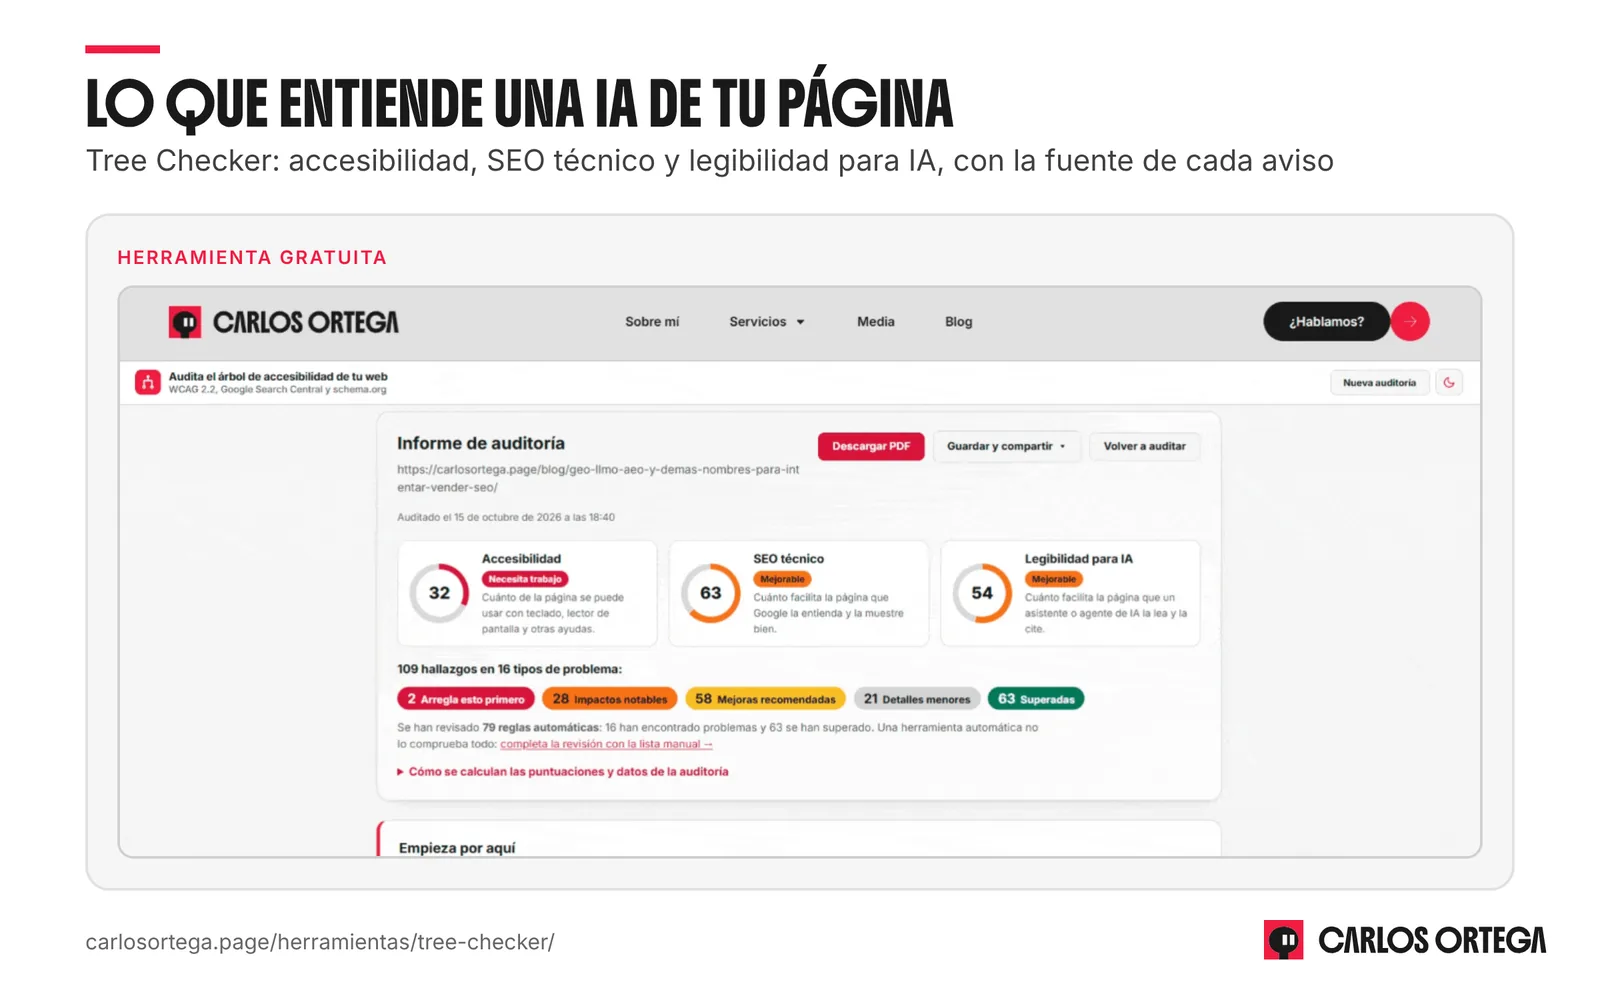
Empieza por lo que más pesa para un agente: botones y enlaces sin nombre, imágenes que hacen de botón sin texto alternativo y formularios con campos sin etiqueta. Arreglar eso ayuda a la vez a las personas con lector de pantalla y a cualquier IA que intente usar tu web.
5. WebMCP
Lo dejo para el final porque es lo más nuevo. Y lo que más me flipa.
WebMCP (Web Model Context Protocol) es una propuesta para que tu web le diga directamente al agente qué puede hacer en ella, en lugar de obligarle a adivinarlo mirando botones y formularios.
Según la documentación de Chrome, está disponible como origin trial desde Chrome 149, y para probarlo en local puedes activarlo desde chrome://flags/#enable-webmcp-testing. Eso sí, es un estándar en desarrollo y todavía puede cambiar.
Si lo piensas, se parece mucho a los datos estructurados. Al final, en general, es JSON igual. La diferencia está en para qué sirve cada cosa:
- Los datos estructurados describen qué es tu contenido.
- Las herramientas de WebMCP describen qué se puede hacer con él.
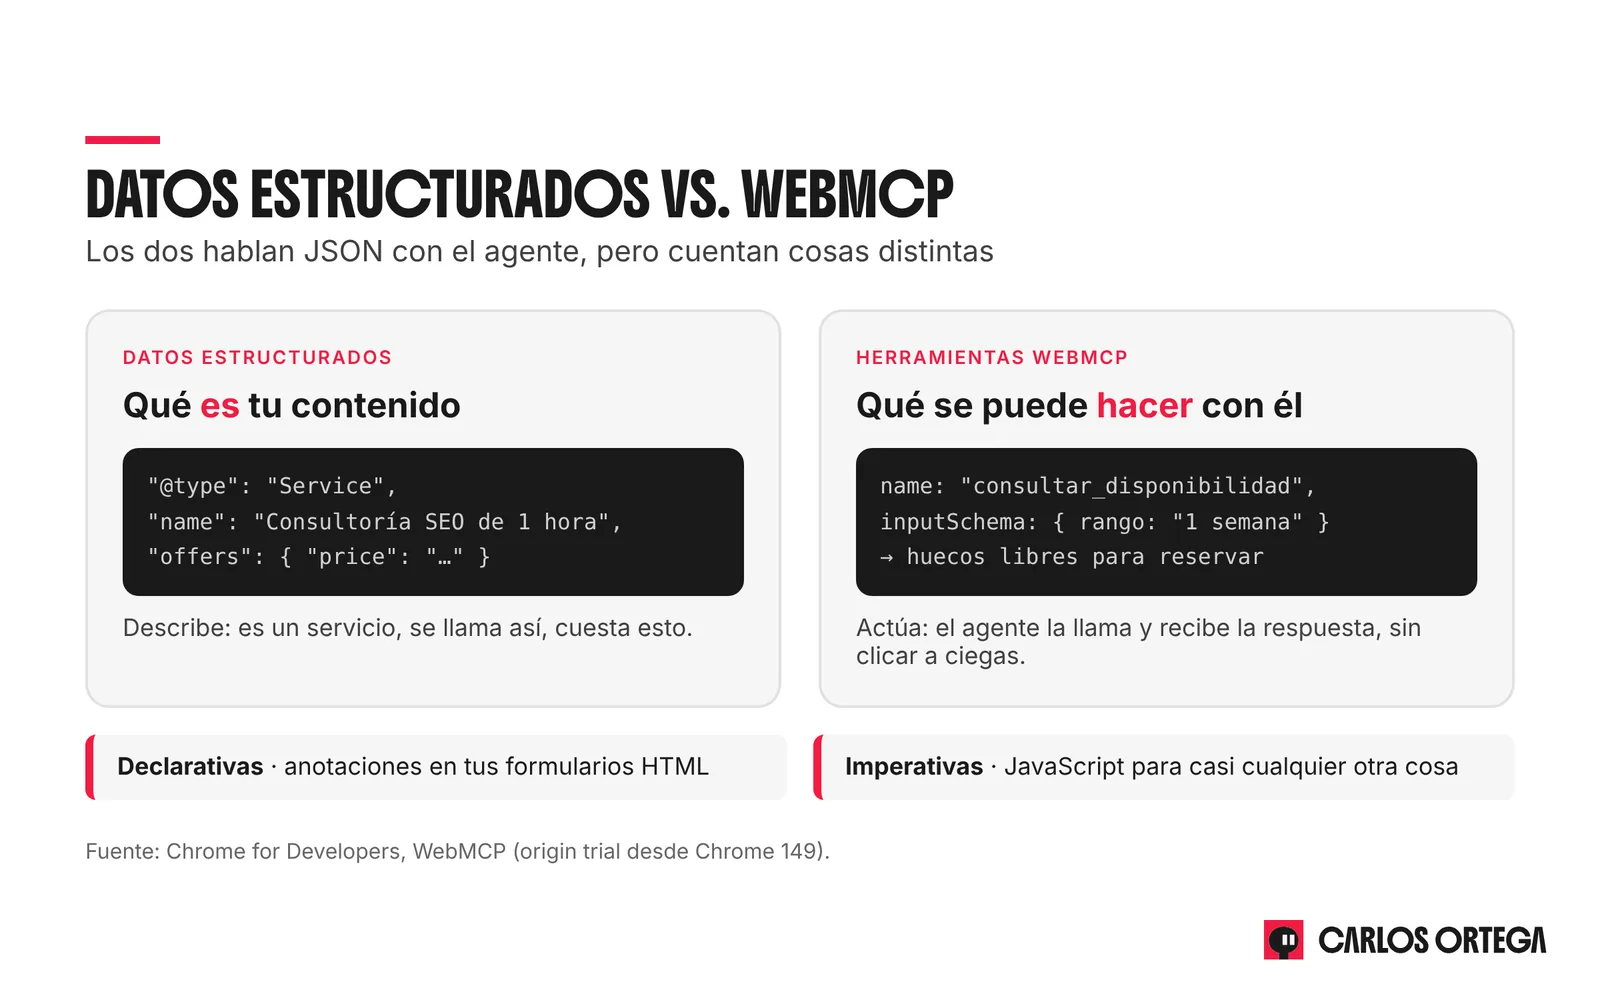
Por ejemplo, así podría registrar en mi web una herramienta para que un agente consulte los huecos libres de la consultoría SEO de 1 hora:
navigator.modelContext.registerTool({
  name: 'consultar_disponibilidad_consultoria',
  description: 'Consulta los próximos huecos libres para reservar la Consultoría SEO de 1 hora',
  inputSchema: {
    type: 'object',
    properties: {
      rango: {
        type: 'string',
        enum: ['3 días', '1 semana', '2 semanas', '1 mes'],
        description: 'Periodo de tiempo hacia adelante a consultar. Por defecto: 1 semana.'
      }
    }
  },
  execute: async ({ rango }) => {
    // (...) consulta el calendario y devuelve los huecos libres
  }
})
Estas herramientas pueden ser de dos tipos:
- Declarativas: unas anotaciones directamente en los formularios HTML que ya tienes.
- Imperativas: con JavaScript, para prácticamente cualquier otra cosa.
¿Y qué es ‘prácticamente cualquier otra cosa’? Pues, por ejemplo, filtrar un catálogo por rango de precios y stock, elegir las fechas de estancia en un calendario de reservas, buscar la política de devoluciones en el centro de ayuda, marcar origen, destino y paradas en un mapa, añadir al carrito un artículo con talla y color concretos o validar el pedido y pasar al pago.
Todo eso que hoy un agente tiene que hacer ‘a ojo’, clicando y rezando para que no se mueva nada, con WebMCP se lo das hecho.
Para ver qué herramientas WebMCP expone una web (la tuya o la de cualquiera) y probarlas con un agente de prueba, hice WebMCP Inspector. Es un marcador del navegador: un clic y te lista todo.
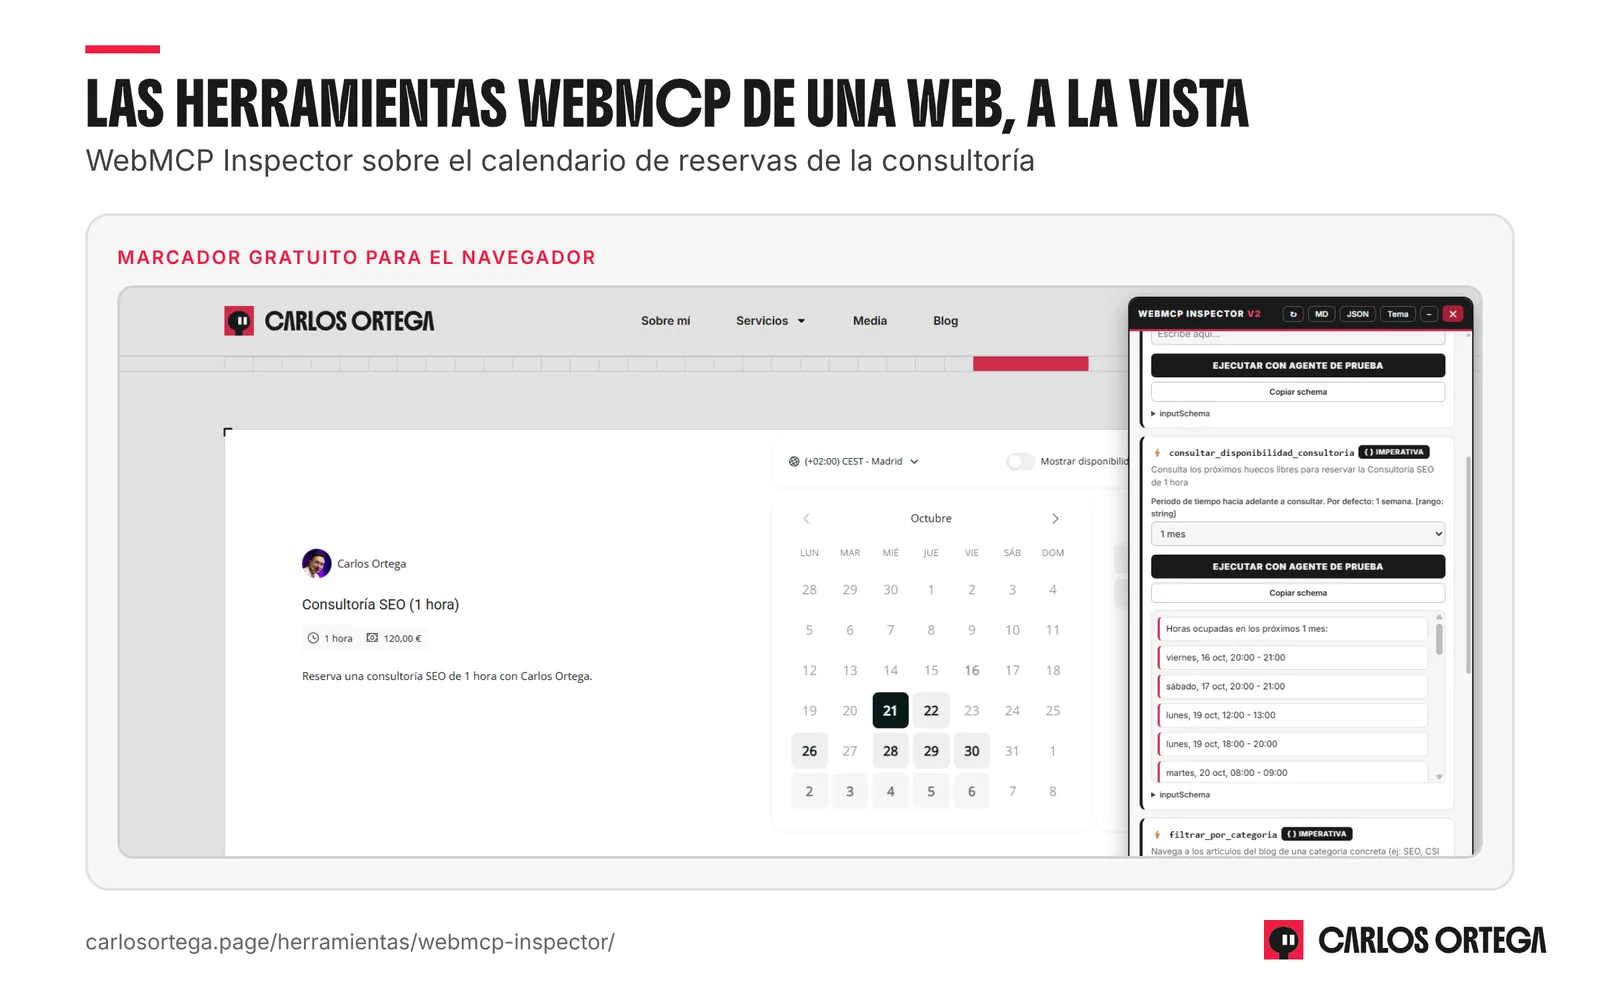
Eso sí, yo lo trataría como una mejora extra, no como la base. Es un estándar todavía en pruebas y puede cambiar, así que de momento lo aprovecharán pocos agentes.
Si te animas, empieza por lo fácil: las herramientas declarativas en los formularios que ya tienes (contacto, presupuesto, reserva), que es casi añadir un par de atributos. Y deja las imperativas para cuando lo anterior (CLS, datos estructurados, encabezados y HTML semántico) ya esté bien resuelto, porque es la base sobre la que se apoya todo.
En resumen
Si lo ordenamos todo, preparar tu web para agentes va de tres capas:
- Que vean bien tu contenido: un buen CLS, que nada baile.
- Que lo entiendan: datos estructurados, encabezados y HTML semántico.
- Que puedan interactuar con él: landmarks y ARIA bien puestos y, si te animas, WebMCP.
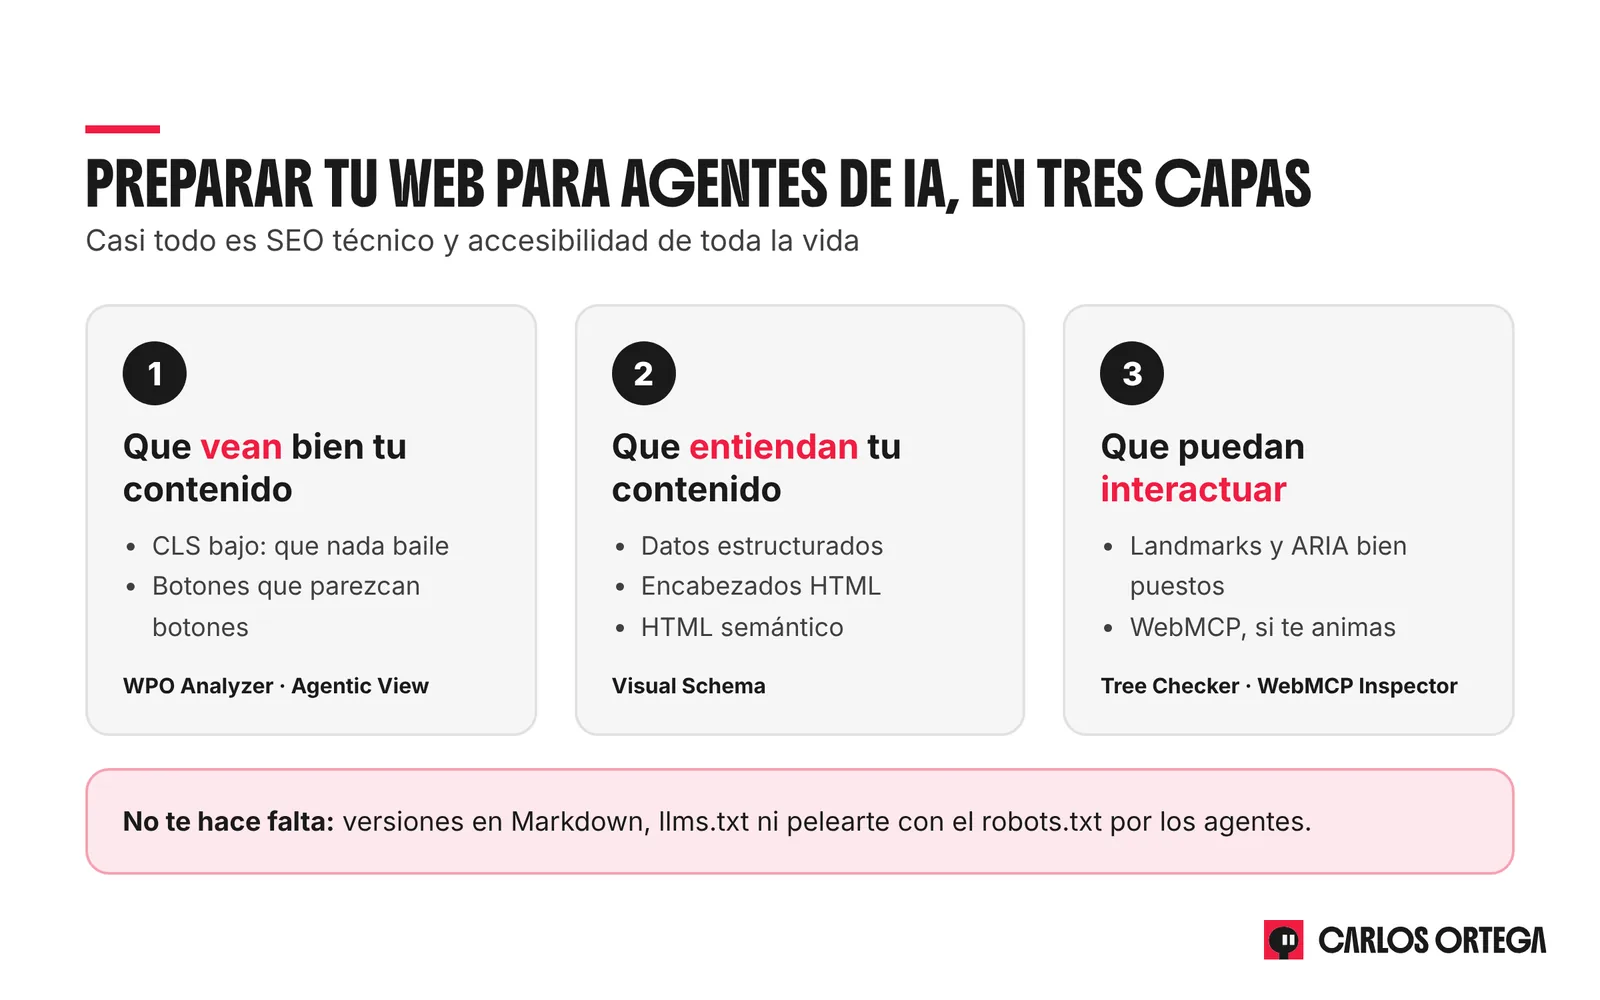
¿Y lo de los Markdown, el llms.txt y pelearte con el robots.txt por los agentes? Déjalo estar. Hay muchas cosas que de verdad mueven la aguja como para perder el tiempo en esas.
Lo curioso es que casi nada de lo que funciona con los agentes es nuevo. Es SEO técnico y accesibilidad de toda la vida. Lo que llevamos años pidiendo a IT.
Al final, una web bien hecha para personas es, en gran parte, una web bien hecha para agentes. Ahora solo tenemos un motivo más para hacerla bien.
Y si quieres revisar la tuya, aquí tienes todas las herramientas gratuitas que han ido saliendo:
- Agentic View: cómo ve un agente tu página.
- WPO Analyzer: rendimiento y estabilidad visual.
- Visual Schema: tus datos estructurados en un grafo.
- Tree Checker: el árbol de accesibilidad y lo que entiende la IA.
- WebMCP Inspector: las herramientas WebMCP de cualquier web.
Cualquier cosa la comentamos por X, LinkedIn o aquí en los comentarios.
Un abrazo y nos vemos en el próximo artículo 🙂